ما هي HTML؟ كيف يقرأ المتصفح الصفحة ولماذا تهم العناصر الدلالية
 aldawsari
ما هي HTML؟ هي لغة ترميز تصف بنية الصفحة: هذا عنوان، وهذه فقرة، وهذا رابط، وهذا زر، وهذا نموذج. وليست لغة برمجة، فلا شروط فيها ولا حلقات، لكنها أساس كل صفحة ويب، لأن المتصفح يحولها إلى شجرة عناصر تسمى DOM، ومنها يرسم الصفحة، ومنها تقرأ برامج قراءة الشاشة ومحركات البحث معنى المحتوى. وفي هذا الدليل لا نكتفي بقائمة الوسوم: نفتح صفحات في متصفح Chrome 153 بلا واجهة في المختبر، ونرى كيف يصلح المتصفح كوداً مكسوراً، ونقارن صفحتين متطابقتين في الشكل إحداهما بعناصر دلالية والأخرى بعناصر div فقط، ونختبر ما تفعله HTML الحديثة وحدها دون JavaScript: التحقق من النماذج والتحميل الكسول للصور.
نمر بالهيكل الأساسي، وكيف يصلح المتصفح الأخطاء، والعناصر الدلالية وشجرة الوصول، والتحقق بأداة المدقق، والنماذج الحديثة، ثم التحميل الكسول.
الهيكل الأساسي
<!doctype html>
<html lang="ar" dir="rtl">
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Shop</title>
</head>
<body> ... </body>
</html>
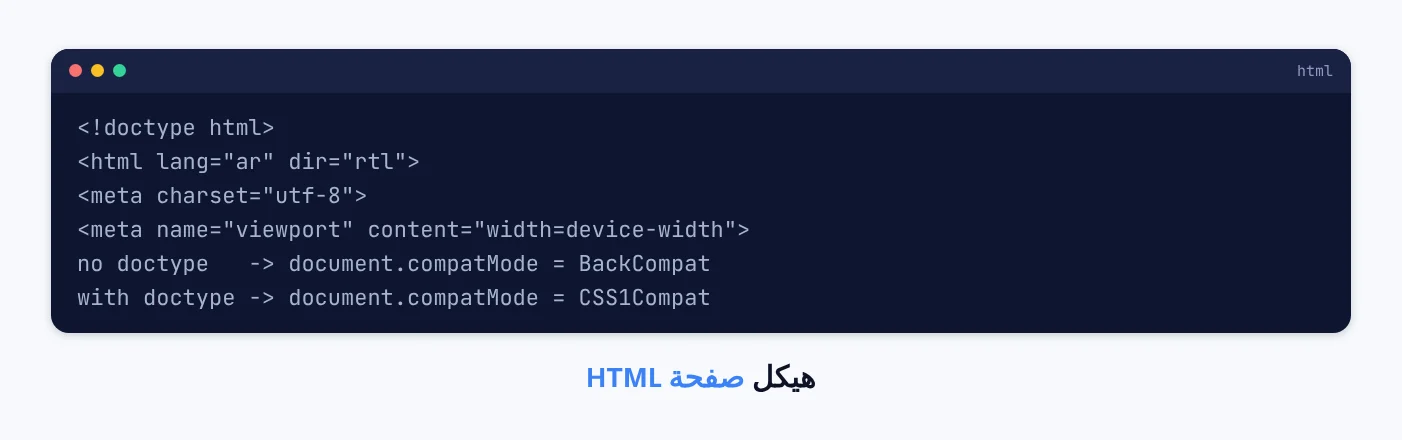
كل سطر هنا له وظيفة. سطر doctype يطلب من المتصفح الوضع القياسي، وبدونه يعمل في وضع التوافق مع الصفحات القديمة، وقسنا ذلك: صفحتنا المكسورة بلا doctype أعطت document.compatMode بقيمة BackCompat، والصفحة السليمة CSS1Compat. وlang وdir يخبران المتصفح وقارئ الشاشة أن النص عربي من اليمين إلى اليسار. وcharset يمنع ظهور الحروف العربية رموزاً غريبة، وviewport يجعل الصفحة تتكيف مع شاشة الجوال. والعنوان في title هو ما يظهر في التبويب وفي نتائج البحث.
كيف يصلح المتصفح الأخطاء
source (no doctype):
<p>first paragraph <p>second <b>bold <i>both</b> italic?</i>
<table><tr><td>cell</td></tr></table>
<ul><li>one<li>two</ul>  <div>unclosed
DOM built by Chrome:
<p>first paragraph </p><p>second <b>bold <i>both</i></b><i> italic?</i>
<table><tbody><tr><td>cell</td></tr></tbody></table>
</p><ul><li>one</li><li>two</li></ul>  <div>unclosed </div>
المتصفح لا يرفض HTML خاطئة أبداً، بل يصلحها بقواعد مكتوبة في المعيار نفسه. أغلق الفقرة الأولى حين بدأت الثانية، وقسم الوسم i المتداخل خطأً إلى قطعتين، وأضاف tbody للجدول، وأغلق عناصر القائمة والـ div. ولاحظ أمراً دقيقاً: الجدول بقي داخل الفقرة الثانية، لأن الصفحة في وضع التوافق، وفي الوضع القياسي تُغلق الفقرة قبل الجدول. فالخطأ لا يكسر الصفحة، لكنه يجعل شكلها يعتمد على قواعد إصلاح قد لا تتوقعها، وهذا سبب كثير من مشكلات التنسيق الغامضة.
العناصر الدلالية وشجرة الوصول
two pages that look the same; Chrome accessibility tree (CDP Accessibility.getFullAXTree)
semantic.html  14 roles: banner, navigation, main, contentinfo, heading "Products",
               article, form, link "Home", link "Blog", heading "Keyboard",
               button "Add", button "Send", textbox "Email", LabelText
               Tab key order: Home, Blog, Add, input, Send
divsoup.html    1 role:  textbox (no name)
               Tab key order: input only (spans with onclick are not focusable)
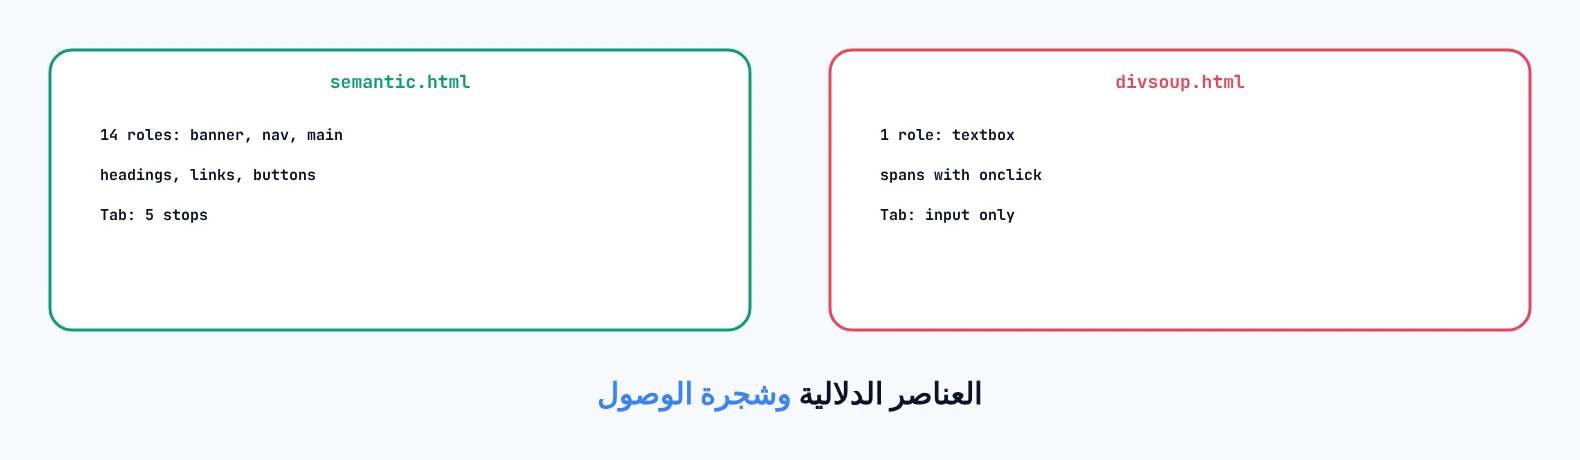
كتبنا الصفحة مرتين. الأولى بعناصر header وnav وmain وarticle وfooter وروابط وأزرار حقيقية، والثانية بعناصر div وspan مع onclick، وهو أسلوب منتشر. وفي شجرة الوصول، وهي ما يقرؤه قارئ الشاشة، ظهر في الأولى 14 دوراً: مناطق للتنقل السريع، وعنوانان، ورابطان، وزران، وحقل بريد باسمه. وفي الثانية دور واحد: حقل بلا اسم. وبمفتاح Tab تنقلنا في الأولى بين خمسة عناصر، وفي الثانية لم نصل إلا إلى الحقل، فلا يستطيع من لا يستخدم الفأرة أن يضغط «Add» أصلاً. ومحركات البحث تقرأ البنية نفسها، والتفاصيل في تحسين محركات البحث.
التحقق بأداة المدقق
html5validator (Nu Html Checker, vnu.jar on Java)
broken.html    5 errors: no doctype | end tag "b" violates nesting rules |
               "table" not allowed as child of "p" | EOF with open elements | unclosed "div"
divsoup.html   0 errors
semantic.html  0 errors
المدقق الرسمي من W3C وجد خمسة أخطاء في الصفحة المكسورة، كل منها مطابق لما أصلحه المتصفح بصمت. لكن انظر إلى السطرين الأخيرين: صفحة div صالحة تماماً بصفر أخطاء، مثل الصفحة الدلالية. فالصلاحية تعني أن الصياغة سليمة، ولا تعني أن العناصر المختارة صحيحة. والمدقق يكشف الوسوم المكسورة، أما اختيار button بدل div فقرارك أنت. والمحرر الجيد يريك أخطاء الصياغة وأنت تكتب، وأدواته في محررات أكواد HTML.
النماذج الحديثة
<input type="email" name="e" required>      (no JavaScript written)
value ''         checkValidity() = false   "Please fill out this field."
value 'abc'      checkValidity() = false   "Please include an '@' in the email address. 'abc' is missing an '@'."
value 'a@b.co'   checkValidity() = true
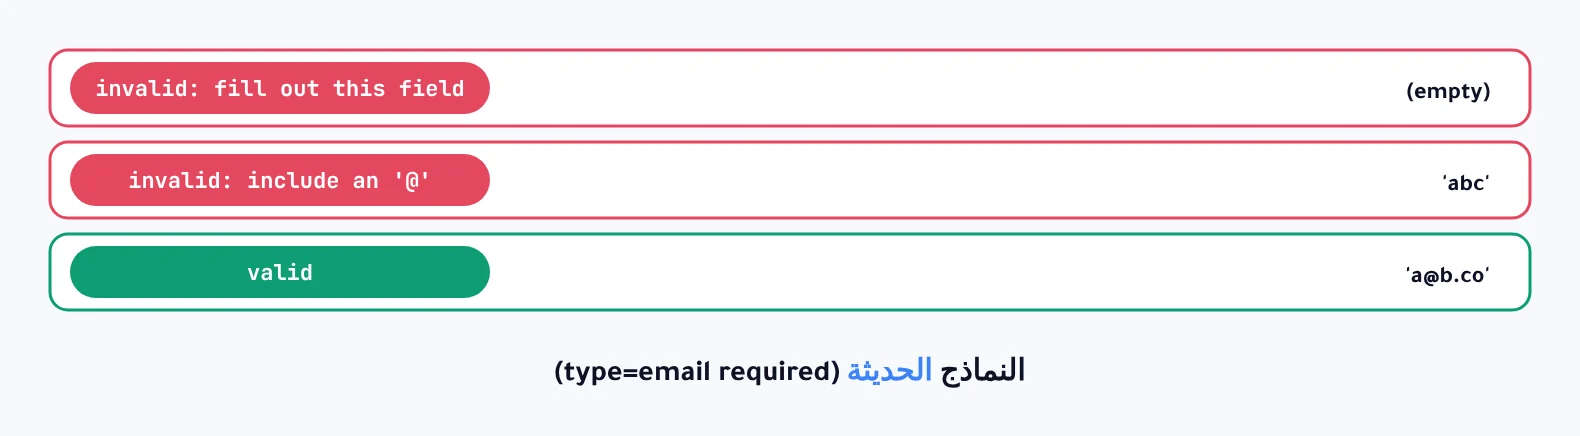
HTML الحديثة تتحقق من النماذج وحدها: النوع email مع required جعل المتصفح يرفض الحقل الفارغ والنص بلا علامة @، برسائل جاهزة بلغة المستخدم، ويقبل العنوان الصحيح، ولم نكتب سطراً من JavaScript. وعلى الجوال يظهر النوع email لوحة مفاتيح فيها @. وهناك أنواع أخرى بالمنطق نفسه: number وdate وtel وurl، وخصائص مثل min وmax وpattern. وتنبيه مهم: هذا التحقق لراحة المستخدم فقط، ويجب أن يتكرر على الخادم، لأن أي شخص يستطيع إرسال الطلب دون المتصفح.
التحميل الكسول للصور
20 images placed below a 3000 px block, viewport 1280x800
eager.html  <img src=... width height alt>                  requests on load: 20   after scroll: 20
lazy.html   <img src=... width height alt loading="lazy">   requests on load: 0    after scroll: 20
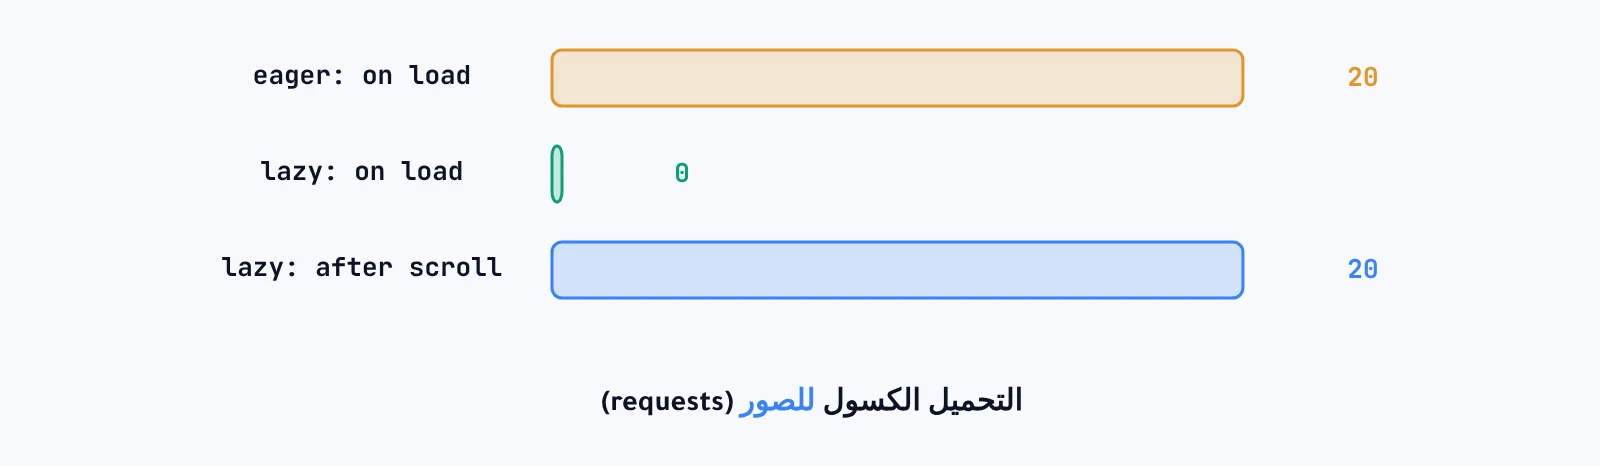
خاصية loading=lazy تؤجل تنزيل الصورة حتى يقترب المستخدم منها. وفي التجربة طلبت الصفحة العادية الصور العشرين كلها عند الفتح، وطلبت الصفحة الكسولة صفراً، ثم العشرين حين نزلنا إلى أسفل الصفحة. وهذا يوفر البيانات ويسرع ظهور أول الصفحة. واكتب دائماً width وheight حتى يحجز المتصفح مكان الصورة فلا يقفز النص، وalt لوصفها لمن لا يراها. ولا تجعل صورة أعلى الصفحة كسولة، لأنها مطلوبة فوراً.
أخطاء شائعة
نسيان doctype
الصفحة دخلت وضع التوافق وتغير مكان الجدول.
div مع onclick بدل button
دور واحد في شجرة الوصول بدل 14، ولا وصول بلوحة المفاتيح.
اعتبار الصلاحية دليل جودة
صفحة div مرت بصفر أخطاء.
الاكتفاء بتحقق المتصفح
التحقق على الخادم إلزامي.
أسئلة يطرحها الناس
هل HTML لغة برمجة؟
لا، هي لغة ترميز تصف البنية، والسلوك من JavaScript والشكل من CSS.
ما الفرق بين HTML5 وHTML الحالية؟
المعيار اليوم «معيار حي» يُحدّث باستمرار، وHTML5 اسم شائع لعناصره الحديثة.
الخلاصة
المتصفح أصلح صفحة مكسورة بلا doctype في وضع التوافق، والمدقق وجد فيها خمسة أخطاء. وصفحتان بالشكل نفسه أعطتا 14 دوراً في شجرة الوصول مقابل دور واحد، ومرتا كلتاهما بصفر أخطاء. وحقل email مع required رفض قيمتين وقبل الثالثة دون JavaScript، والصور الكسولة طُلب منها صفر عند الفتح مقابل عشرين.