كيف تعمل النماذج اللغوية برمجياً: الرموز والحرارة وحلقة التوليد بالقياس
 aldawsari
كيف تعمل النماذج اللغوية برمجياً؟ من خارج الواجهة يبدو النموذج كأنه يكتب جملاً كاملة، لكنه برمجياً يفعل شيئاً واحداً يكرره: يحول النص إلى أرقام تسمى رموزاً tokens، ويحسب لكل رمز ممكن درجة، ثم يختار رمزاً واحداً تالياً، ويضيفه إلى النص، ويعيد الحساب. وكل ما يهم المطور يأتي من هذه الحلقة: كلفة الطلب بعدد الرموز، والعشوائية بالحرارة temperature، وطول المحادثة بنافذة السياق. وفي هذا الدليل نقيس الأجزاء التي تعمل محلياً: نقسم جملاً عربية وإنجليزية بمقسمين حقيقيين من OpenAI، ونحسب أثر الحرارة وtop_p على التوزيع، ونبني حلقة توليد صغيرة، ونقيس نمو الطلب في محادثة. ولم نتصل بأي نموذج عبر الإنترنت، فالمختبر لا يصل إلى واجهات النماذج، ونذكر ذلك عند كل نقطة.
نمر بالرموز وتقسيم النص، والعربية مقابل الإنجليزية، والدرجات والحرارة، وtop_p والعينات، وحلقة التوليد، ثم شكل الطلب ونمو المحادثة.
الرموز وتقسيم النص
import tiktoken                                  # tokenizer library, pip install tiktoken
enc = tiktoken.get_encoding("o200k_base")        # vocab 200,019 tokens (cl100k_base: 100,277)
ids = enc.encode("Large language models predict the next token from the previous ones.")
print(len(ids), [enc.decode([i]) for i in ids])
# 12 ['Large', ' language', ' models', ' predict', ' the', ' next', ' token', ' from', ...]
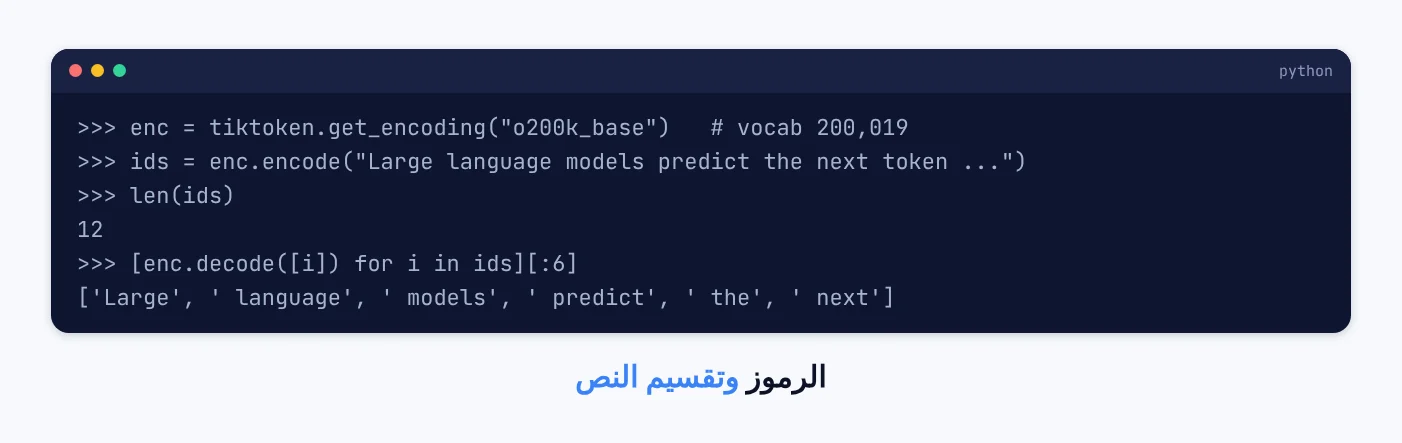
النموذج لا يرى حروفاً ولا كلمات، بل أرقاماً من قاموس ثابت. والمقسم يقسم النص إلى أجزاء متكررة تعلمها من بيانات ضخمة، فالكلمة الإنجليزية الشائعة رمز واحد غالباً مع المسافة التي قبلها. والمكتبة tiktoken تحتاج ملف القاموس، وتنزله عادة من خوادم OpenAI المحجوبة عن المختبر، فاستخدمنا نسختي cl100k_base وo200k_base المضمنتين في حزمة pip أخرى هي litellm، وفحصتهما tiktoken ببصمتهما قبل التحميل. والقاموس الأول بحجم 100,277 رمزاً، والثاني ضعفه تقريباً.
العربية مقابل الإنجليزية
text (same meaning)      chars  words   cl100k_base tokens   o200k_base tokens
English sentence           68     11          12 (5.67 c/t)        12 (5.67 c/t)
Arabic sentence            65      9          42 (1.55 c/t)        18 (3.61 c/t)
Python code (2 lines)      36      7          13 (2.77 c/t)        13 (2.77 c/t)
first Arabic tokens (cl100k): bytes d8a7d984 | d986 | d985 | d8a7   (al-, n, m, a)
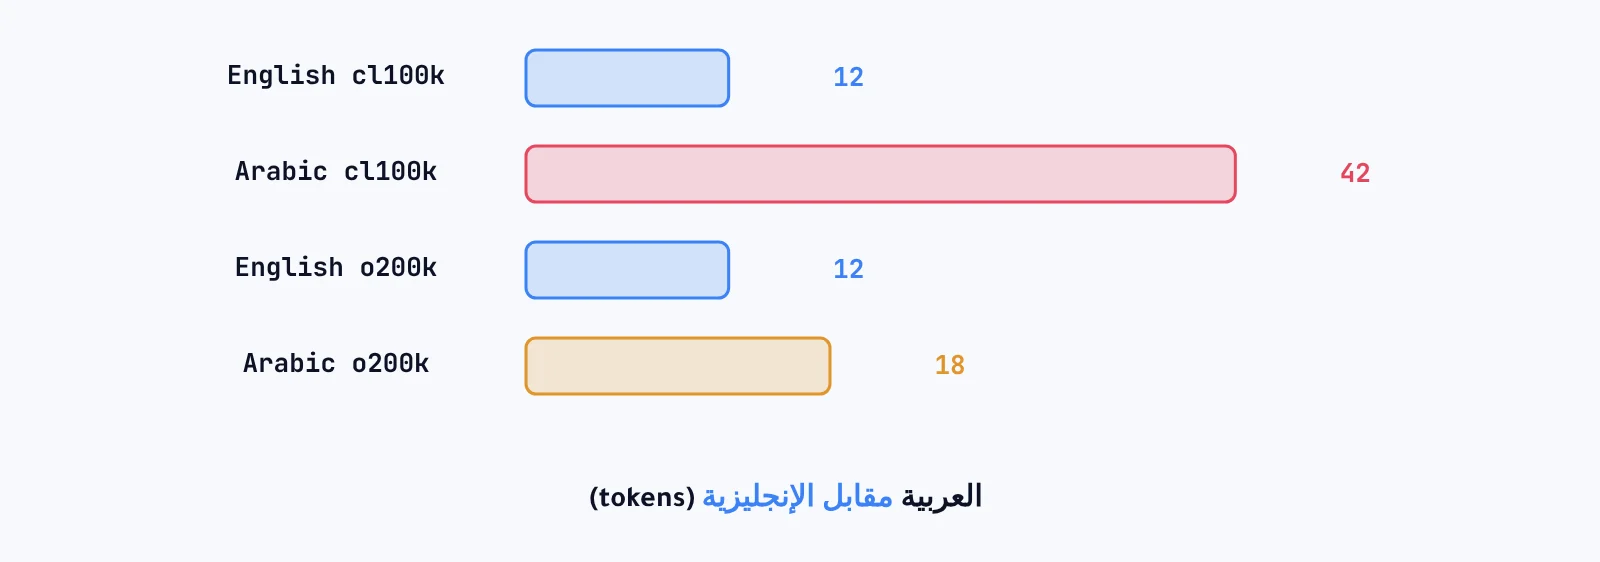
الجملة العربية بالمعنى نفسه احتاجت 42 رمزاً في القاموس الأقدم، أي ثلاثة أضعاف ونصف الإنجليزية، لأنه لم يرَ عربية كافية فيقسمها حرفاً أو حرفين: أداة التعريف رمز، ثم كل حرف رمز. وفي القاموس الأحدث نزلت إلى 18 رمزاً. وهذا رقم له ثمن مباشر، فالواجهات تحاسب بعدد الرموز وتحد نافذة السياق بها، فالنص العربي نفسه قد يكلف ضعفين أو أكثر حسب مقسم النموذج. فقس نصوصك بمقسم النموذج الذي تستخدمه قبل أن تقدر الكلفة. ومفاهيم النماذج التوليدية عموماً في هندسة النماذج اللغوية التوليدية.
الدرجات والحرارة
illustrative logits after "The capital of France is" (chosen by hand, not from a model):
Paris 9.1   the 6.0   a 5.2   Lyon 4.6   located 4.1   not 2.5
softmax(logits / T):
T=0.2   Paris=1.000                                   entropy 0.00 bits
T=0.7   Paris=0.982  the=0.012  a=0.004               entropy 0.15 bits
T=1.0   Paris=0.922  the=0.042  a=0.019  Lyon=0.010   entropy 0.53 bits
T=1.5   Paris=0.770  the=0.097  a=0.057  Lyon=0.038   entropy 1.24 bits
في آخر طبقة يخرج النموذج درجة لكل رمز في القاموس، تسمى logits، ودالة softmax تحولها إلى احتمالات مجموعها واحد. والحرارة تقسم الدرجات قبل softmax: الحرارة المنخفضة تكبر الفروق فيأخذ الرمز الأول كل الاحتمال، والمرتفعة تقربها فيأخذ غيره نصيباً. والدرجات هنا وضعناها بأيدينا للتوضيح، لأننا لا نشغل نموذجاً حقيقياً، لكن الحساب نفسه هو ما يجري داخل كل نموذج. والإنتروبيا تقيس مقدار التردد: صفر عند 0.2، و1.24 بت عند 1.5.
top_p والعينات
top_p = 0.9 keeps the smallest set whose probability sum reaches 0.9
T=1.0   keeps 1 token   ['Paris']
T=1.5   keeps 3 tokens  ['Paris', 'the', 'a']
10,000 random draws (seed 42):
T=0.2   Paris 10000   other 0      distinct 1
T=1.0   Paris  9193   other 807    distinct 6
T=1.5   Paris  7760   other 2240   distinct 6
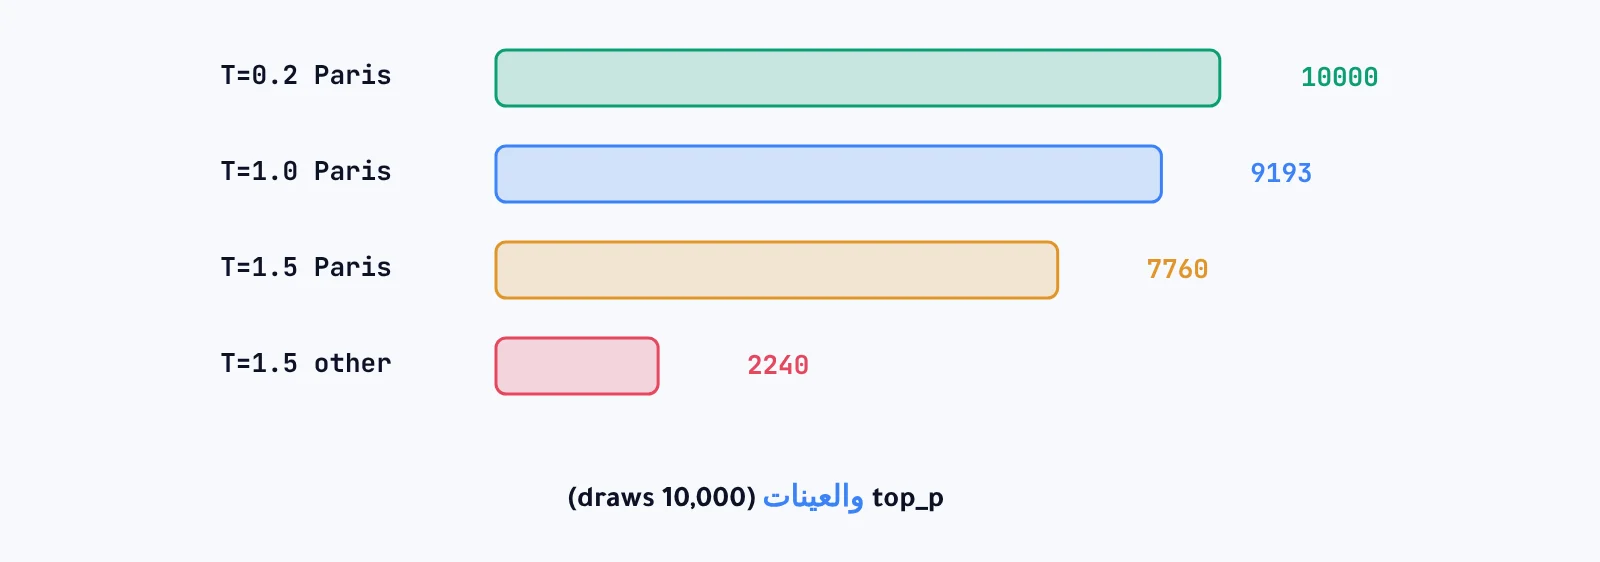
سحبنا عشرة آلاف عينة لكل حرارة: عند 0.2 كانت كلها Paris، وعند 1.5 خرجت 2,240 عينة بكلمة أخرى، أي واحدة من كل أربع تقريباً. وtop_p يقص الذيل: يبقي أقل مجموعة رموز يبلغ مجموع احتمالها 0.9، فعند الحرارة 1.0 بقي رمز واحد، وعند 1.5 بقيت ثلاثة، فلا تظهر الكلمات النادرة جداً مثل not مهما كانت العشوائية. والقاعدة العملية: حرارة منخفضة للاستخراج والتصنيف والكود، وأعلى قليلاً للكتابة الإبداعية، ولا ترفع الحرارة وtop_p معاً.
حلقة التوليد
toy model: word bigram counts from the Zen of Python (166 words, 90 distinct, 143 pairs)
after 'is': better 7, often 1, hard 1, easy 1
greedy, seed 1   : beautiful is better than ugly . although practicality beats purity .
greedy, seed 2   : beautiful is better than ugly . although practicality beats purity .
T=1.0, seed 1    : beautiful is hard to guess . although that way to break
T=1.0, seed 2    : beautiful is easy to break the implementation is better than nested
لنرى الحلقة نفسها بنينا أصغر نموذج ممكن: يعد في نص قصير كم مرة جاءت كل كلمة بعد أخرى، ويستخدم لوغاريتم العدد كدرجة. والحلقة هي نفسها في النماذج الكبيرة: خذ آخر رمز، احسب الدرجات، اختر واحداً، أضفه، كرر. واختيار الأعلى دائماً، ويسمى greedy، أعطى الجملة نفسها في كل تشغيل، والحرارة 1.0 أعطت جملتين مختلفتين بالبذرتين. والفرق أن النموذج الكبير ينظر إلى آلاف الرموز السابقة لا إلى كلمة واحدة، ويحسب الدرجات بشبكة عصبية فيها مليارات الأوزان.
شكل الطلب ونمو المحادثة
request body (generic chat API shape, built locally, not sent):
{"model": "MODEL_NAME", "max_tokens": 300, "temperature": 0.2,
 "messages": [{"role": "system", "content": "..."}, {"role": "user", "content": "..."}]}
every turn resends the whole history (o200k_base, content tokens only):
turn 1: messages 2   input ~27 tokens    cumulative ~27    json 260 B
turn 3: messages 6   input ~83 tokens    cumulative ~165   json 642 B
turn 5: messages 10  input ~139 tokens   cumulative ~415   json 1024 B
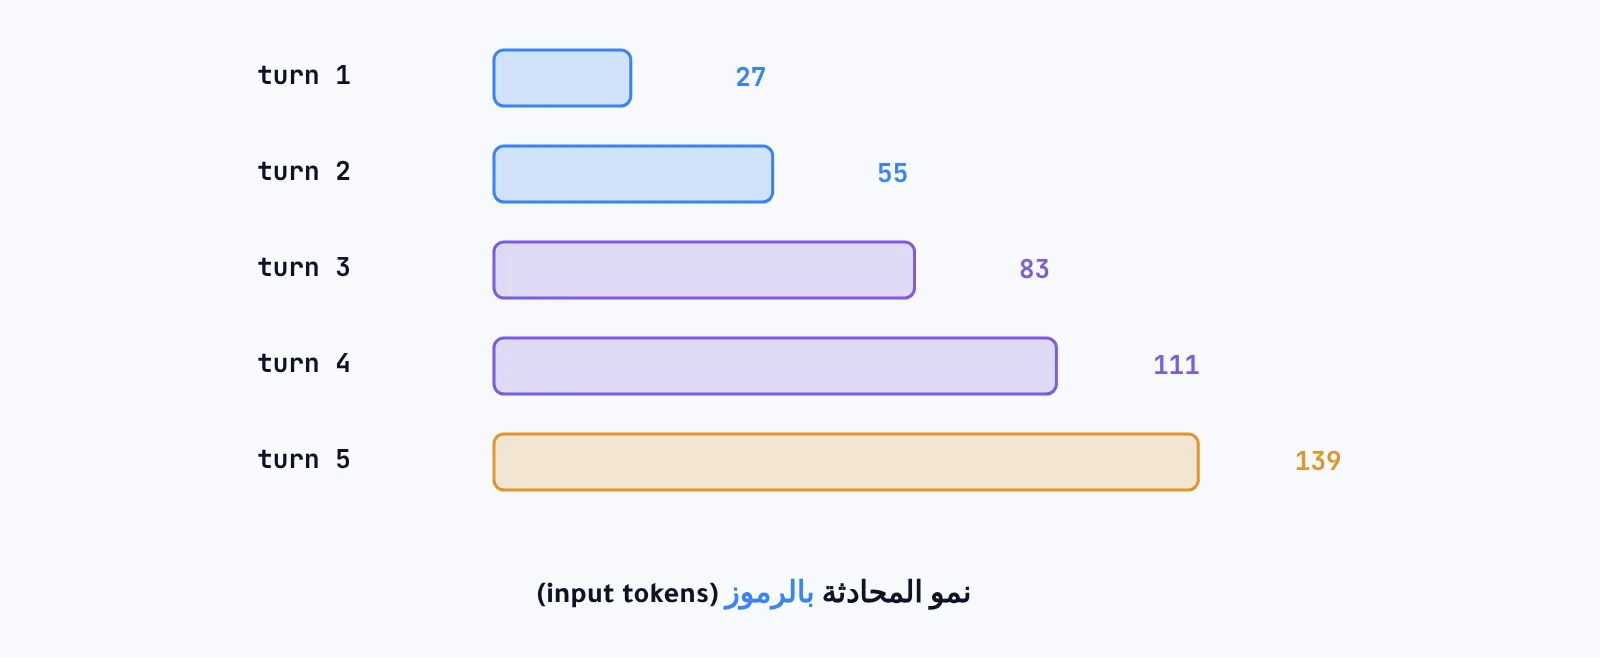
واجهات النماذج بلا ذاكرة بين الطلبات: كل طلب يحمل التعليمات والمحادثة كاملة، والرد رسالة جديدة تضيفها أنت إلى القائمة. فقسنا محادثة دعم بخمس جولات متشابهة: الجولة الخامسة أرسلت 139 رمزاً بدل 27، ومجموع ما أُرسل 415 رمزاً، فالكلفة تنمو أسرع من عدد الرسائل. والأرقام تقريبية لأنها لا تحسب الرموز الإضافية التي تفصل الرسائل في كل واجهة. ولم نرسل الطلب، فلم نقس زمن الرد ولا شكل الرد الفعلي، الذي يحمل عادة النص وسبب التوقف وعدد الرموز المستهلكة. ولتجهيز بيئة Python التي تشغل هذه السكربتات راجع تجهيز بيئة Python للذكاء الاصطناعي.
أخطاء شائعة
تقدير الكلفة بعدد الكلمات
تسع كلمات عربية كانت 42 رمزاً.
حرارة عالية لمهمة دقيقة
عند 1.5 خرجت إجابة أخرى في ربع العينات.
إرسال المحادثة كلها بلا حد
اقطع القديم أو لخصه قبل أن تبلغ نافذة السياق.
توقع النتيجة نفسها في كل مرة
مع الحرارة فوق الصفر تختلف المخرجات، فاختبر بعدة تشغيلات.
أسئلة يطرحها الناس
هل الحرارة صفر تعطي نتيجة ثابتة دائماً؟
تقترب من greedy، لكن بعض الواجهات لا تضمن التطابق التام بسبب الحساب المتوازي.
لماذا يختلف عدد الرموز بين النماذج؟
لكل نموذج مقسمه وقاموسه، فالجملة العربية نفسها كانت 42 رمزاً في قاموس و18 في آخر.
الخلاصة
النموذج اللغوي حلقة: رموز ثم درجات ثم اختيار ثم تكرار. والجملة الإنجليزية كانت 12 رمزاً في المقسمين، والعربية 42 ثم 18. والحرارة 0.2 جعلت Paris في كل العينات العشرة آلاف، و1.5 أخرجت غيرها في 2,240 عينة، وtop_p أبقى رمزاً واحداً أو ثلاثة. والمحادثة ذات الجولات الخمس أرسلت 415 رمزاً متراكمة. ولم نتصل بنموذج حقيقي، فزمن الرد وشكله الفعلي غير مقاسين هنا.