تجهيز بيئة Python للذكاء الاصطناعي وعلوم البيانات: venv وuv وJupyter بالقياس
 aldawsari
تجهيز بيئة Python للذكاء الاصطناعي وعلوم البيانات هو أول عمل في أي مشروع، وأخطاؤه تظهر متأخرة: مكتبات مثبتة على Python النظام فتتعارض مع أدواته، أو مشروع لا يعمل عند زميلك لأن أحداً لم يسجل الإصدارات، أو Jupyter يشغل Python غير الذي ثبت فيه المكتبات. وفي هذا الدليل نجهز بيئة كاملة على Python 3.13 في المختبر بالحزم الأساسية: NumPy وpandas وscikit-learn وmatplotlib مع نواة Jupyter، ونقيس كل خطوة: زمن الإنشاء والتثبيت بأداتي pip وuv، والحجم على القرص، وزمن استيراد كل مكتبة، ونموذجاً صغيراً يتأكد أن البيئة تعمل، ثم نعيد إنتاج البيئة من ملف الإصدارات ونقارن.
نمر بلماذا البيئة الافتراضية، والتثبيت بـ pip وuv ومقارنتهما، والحجم وزمن الاستيراد، والتحقق بنموذج صغير، وربط البيئة بـ Jupyter، ثم تسجيل الإصدارات وإعادة الإنتاج، ومعالج الرسوم.
لماذا البيئة الافتراضية
$ python3 -m venv .venv-pip                 real 1.964 s
outside: which python3 -> /usr/local/bin/python3
inside (after source .venv-pip/bin/activate): which python -> .../l55/.venv-pip/bin/python
sys.prefix       .../l55/.venv-pip
sys.base_prefix  /usr/local
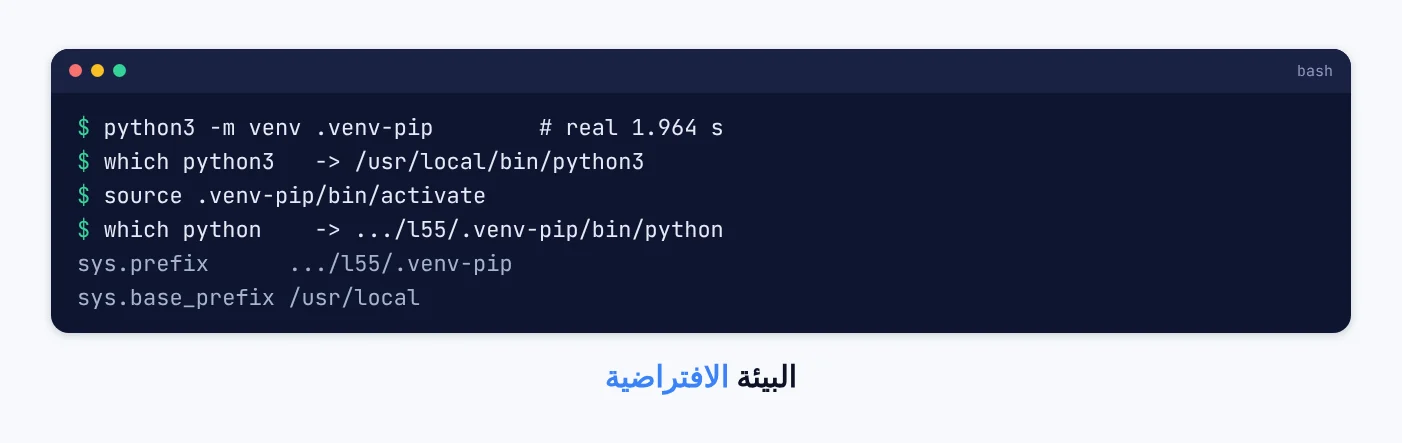
البيئة الافتراضية مجلد فيه نسخة خفيفة من مفسر Python ومجلد مكتبات خاص بالمشروع، وأنشأناها في أقل من ثانيتين. وبعد تفعيلها يشير الأمر python إلى مفسر البيئة، ويعرف Python أنه داخلها لأن sys.prefix يختلف عن sys.base_prefix. والفائدة أن كل مشروع له إصداراته دون أن يمس غيره، ودون صلاحيات root، ودون أن يكسر أدوات النظام التي تعتمد على Python التوزيعة. وعلى أوبونتو الحديثة يرفض pip أصلاً التثبيت في Python النظام بسبب علامة PEP 668. وما هي Python وكيف تعمل في ما هي لغة Python.
التثبيت بـ pip وuv
packages: numpy pandas scikit-learn matplotlib ipykernel   (45 installed with dependencies)
pip install --no-cache-dir           9.692 s
uv venv + uv pip install (empty cache)  2.987 s
uv again into a new venv (warm cache)   0.225 s
versions: numpy 2.5.4  pandas 3.1.1  scikit-learn 1.9.1  matplotlib 3.11.2
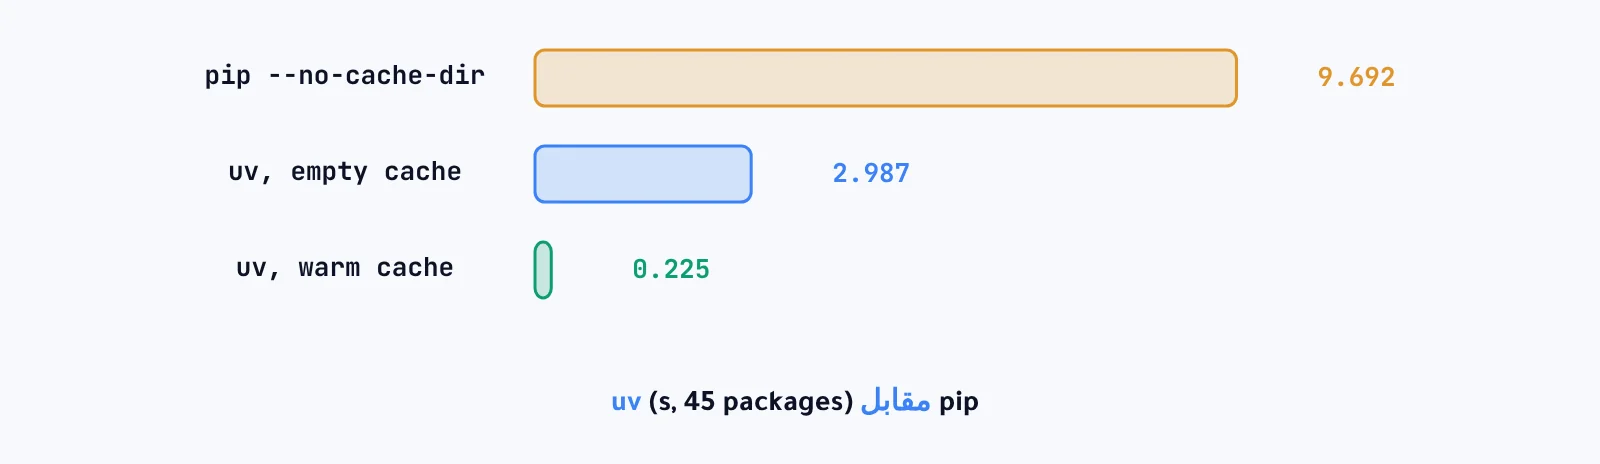
الحزم الخمس جلبت معها 40 حزمة أخرى. وpip أخذ قرابة عشر ثوانٍ، وuv أخذ ثلاث ثوانٍ بذاكرة مؤقتة فارغة، لأنه ينزل ويفك الحزم بالتوازي. وفي المرة الثانية، لبيئة جديدة بالحزم نفسها، أخذ ربع ثانية، لأنه يربط الملفات من ذاكرته المؤقتة بروابط صلبة بدل نسخها. وهذا فرق كبير حين تنشئ بيئات كثيرة للتجارب أو في خطوط CI. والشبكة في المختبر سريعة، فعلى اتصال أبطأ يكبر زمن pip أكثر.
الحجم وزمن الاستيراد
du -sh   .venv-pip 412M   .venv-uv 399M   .venv-uv2 9.1M (hard links into the uv cache)
import time (third run, warm disk cache):
numpy               0.043 s
pandas              0.176 s
matplotlib.pyplot   0.418 s
sklearn             0.835 s
البيئة الواحدة بهذه الحزم قرابة 400 ميغابايت، والبيئة الثانية من uv لم تضف إلا 9.1 ميغابايت لأن ملفاتها روابط إلى الملفات نفسها. وزمن الاستيراد مهم للسكربتات القصيرة التي تعمل كثيراً: استيراد scikit-learn وحده قرابة ثانية، فلا تستورده في سكربت لا يحتاجه. وتنبيه: هذه أرقام القرص بعد القراءة الأولى، وأول استيراد بعد إقلاع الجهاز أبطأ.
التحقق بنموذج صغير
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
X, y = load_digits(return_X_y=True)              # bundled dataset, no download
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, random_state=0)
m = LogisticRegression(max_iter=2000).fit(Xtr, ytr)
# digits (1797, 64), test accuracy 0.953, 1.32 s
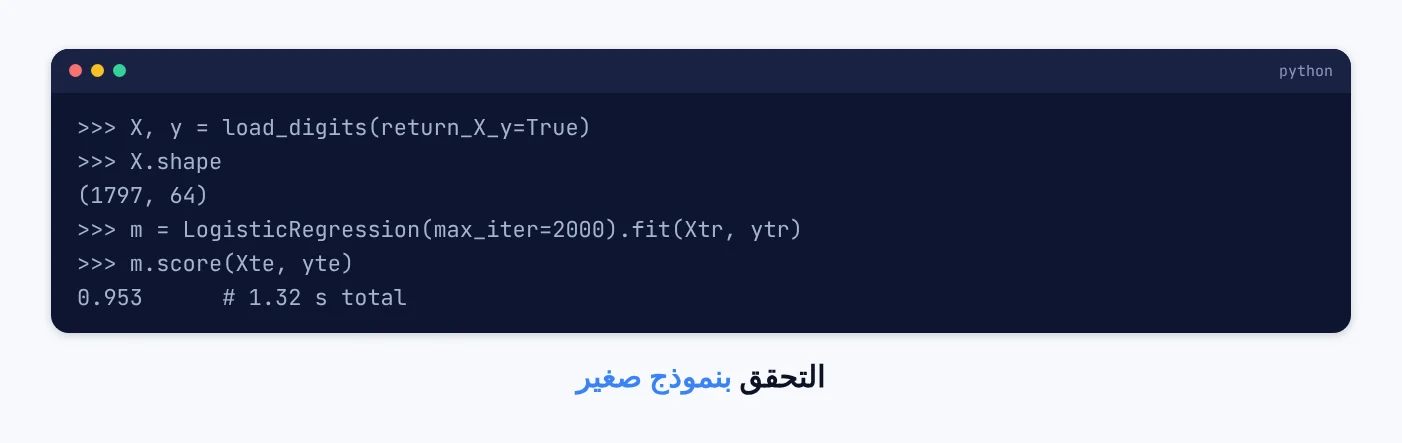
نجاح التثبيت لا يعني أن البيئة تعمل، فبعض الحزم تحتاج مكتبات نظام قد تنقص. وأبسط فحص نموذج كامل على بيانات مضمنة في المكتبة لا تحتاج تنزيلاً: 1,797 صورة لأرقام مكتوبة بخط اليد، كل صورة 64 قيمة. ودرب النموذج وقيّم نفسه في 1.32 ثانية بدقة 0.953 على ربع البيانات الذي لم يره. وإن أعطاك هذا السكربت الرقم نفسه بالبذرة نفسها على جهاز آخر، فالبيئتان متطابقتان في ما يهم.
ربط البيئة بـ Jupyter وإعادة الإنتاج
$ python -m ipykernel install --prefix ./jup --name ds-lab
kernel.json: "argv": [".../.venv-pip/bin/python", "-Xfrozen_modules=off", "-m", "ipykernel_launcher", ...]
$ pip freeze > requirements.txt              44 lines (asttokens==3.0.2, cloudpickle==3.1.2, ...)
$ uv venv .venv-copy && uv pip install -r requirements.txt     real 0.236 s
diff of both freezes: only name spelling (jupyter_core vs jupyter-core), same 44 versions
أكثر مشكلة شائعة مع Jupyter أن تثبت المكتبة في بيئة ويشغل الدفتر نواة من بيئة أخرى، فيظهر خطأ «لا توجد وحدة» مع أنك ثبتها للتو. والحل تسجيل البيئة كنواة باسمها، فملف kernel.json يشير صراحة إلى مفسر البيئة، وتختاره من قائمة النوى في Jupyter أو VS Code. ثم سجل الإصدارات: pip freeze كتب 44 سطراً بأرقام دقيقة، وبيئة جديدة منه أخذت ربع ثانية بالذاكرة المؤقتة، وتطابقت الإصدارات كلها، والفرق الوحيد كتابة الأسماء بشرطة أو شرطة سفلية. ولماذا لا يكفي هذا الملف وحده أحياناً، في يعمل على جهازي وانحراف البيئات.
معالج الرسوم وGPU
$ nvidia-smi
nvidia-smi: command not found          # no GPU in this lab
documented, not run here:
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU-only wheel
pip install torch                                                       # Linux default wheel uses CUDA
python -c "import torch; print(torch.cuda.is_available())"
المختبر بلا معالج رسوم، فلم نثبت PyTorch ولم نقس شيئاً هنا. والقاعدة الموثقة: على جهاز بلا بطاقة NVIDIA ثبت نسخة المعالج من الفهرس الخاص بها لأنها أصغر بكثير، وعلى جهاز ببطاقة يجب أن يكون تعريف البطاقة أحدث من إصدار CUDA الذي بُنيت عليه الحزمة. وتحقق دائماً بسطر torch.cuda.is_available بعد التثبيت، فهو يقول لك في ثانية إن كانت المكتبة ترى البطاقة. وأنشئ لمشاريع التعلم العميق بيئة منفصلة عن بيئة التحليل، لأن حجمها أكبر بكثير.
أخطاء شائعة
التثبيت في Python النظام
يكسر أدوات التوزيعة، وpip الحديث يرفضه.
نواة Jupyter من بيئة أخرى
سجل البيئة بـ ipykernel باسم واضح.
مشروع بلا ملف إصدارات
44 سطراً من freeze تكفي لإعادة البيئة.
رفع مجلد البيئة إلى Git
400 ميغابايت لا مكان لها في المستودع، والملف يكفي.
أسئلة يطرحها الناس
هل أستخدم Conda أم venv؟
Conda مفيدة حين تحتاج مكتبات غير Python كبعض أدوات CUDA، وvenv مع uv يكفي أغلب مشاريع علوم البيانات. ولم نقس Conda هنا.
أين أنشئ مجلد البيئة؟
داخل مجلد المشروع باسم .venv مع إضافته إلى ملف .gitignore.
الخلاصة
أنشأنا البيئة في 1.96 ثانية، وثبت pip الحزم الخمس مع 40 تابعاً في 9.7 ثانية، وuv في 3.0 ثوانٍ ثم في 0.23 ثانية بالذاكرة المؤقتة. والبيئة قرابة 400 ميغابايت، واستيراد scikit-learn 0.84 ثانية، والنموذج الصغير أعطى دقة 0.953 في 1.32 ثانية، وملف freeze من 44 سطراً أعاد البيئة نفسها في ربع ثانية.