مراقبة المعالج والذاكرة في لينكس: مؤشرات الضغط PSI والخنق عبر cgroups بالأرقام
 aldawsari
مراقبة المعالج والذاكرة في لينكس لا تكتمل بنسبة الاستخدام وحدها. خادم يعمل معالجه بنسبة 100 بالمئة قد يكون بخير إن لم ينتظر أحد، وخادم بنسبة 60 بالمئة قد يكون مخنوقاً إن كانت خدمته محصورة في مجموعة تحكم cgroup بحد صارم. والسؤال الأدق: كم من الوقت انتظرت المهام موارد لم تحصل عليها؟ هذا ما تجيب عنه مؤشرات الضغط PSI وعدّادات الخنق في cgroups. وفي هذا المقال نحمّل معالجين في آلة QEMU بنواة أوبونتو 6.8، ونقارن متوسط الحمل بمؤشر PSI، ثم نخنق عملية بحد 20 بالمئة ونقرأ عدّاداتها، ونوزع المعالج بالأوزان، ونخنق الذاكرة دون قتل.
نمر بمتوسط الحمل وحدوده، وقراءة PSI، والخنق بالحد cpu.max، والأوزان cpu.weight، وخنق الذاكرة بالحد memory.high، ثم أين تجد هذه الأرقام في الإنتاج.
متوسط الحمل لا يكفي
stress-ng --cpu 4 --cpu-method int64 -t 20 &    # 4 busy workers on 2 vCPUs
sleep 15
cat /proc/loadavg           # 1.63 0.42 0.14 5/94 200
cat /proc/pressure/cpu      # some avg10=77.26 avg60=26.44 avg300=6.47
vmstat 1 3                  # r=4  us=99..100  id=0
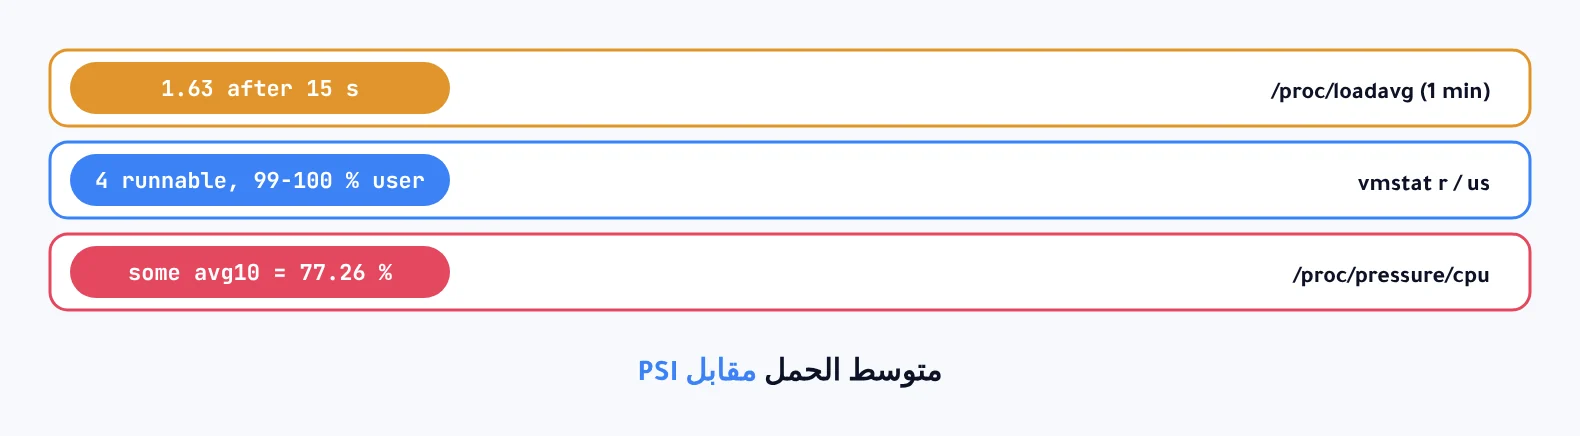
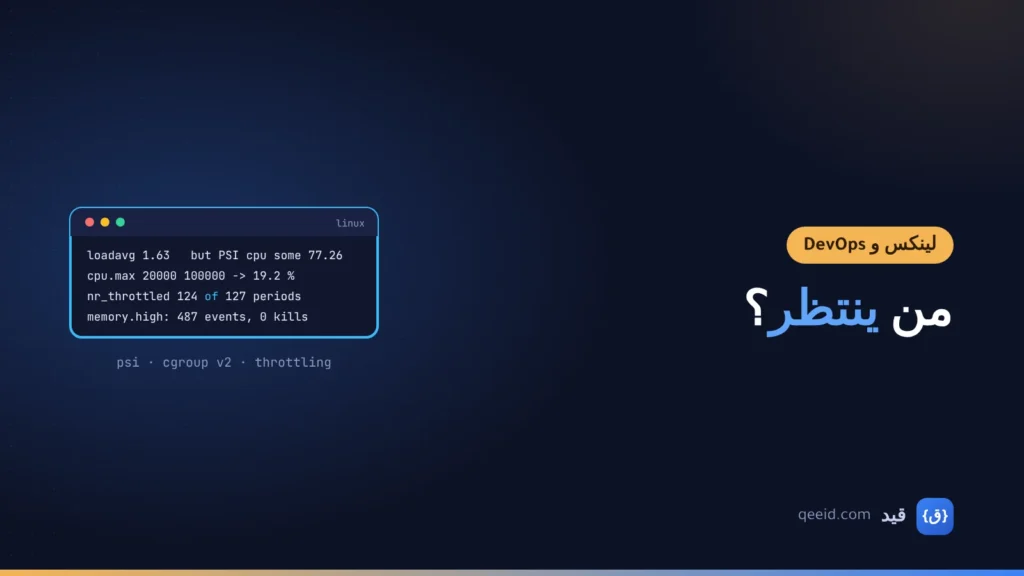
شغّلنا أربعة عمال على معالجين، أي أن نصف المهام تنتظر دائماً. بعد 15 ثانية كان متوسط الحمل للدقيقة 1.63 فقط، لأنه متوسط متحرك يحتاج دقائق ليصل إلى 4. والعمود r في vmstat أظهر 4 مهام جاهزة، والمعالج مشغول بالكامل. أما PSI فقال مباشرة إن 77 بالمئة من آخر عشر ثوانٍ كانت فيها مهمة واحدة على الأقل تنتظر المعالج. والفرق أن الحمل رقم مطلق يجب أن تقسمه على عدد المعالجات، ويخلط بين انتظار المعالج وانتظار القرص، بينما PSI نسبة زمنية لكل مورد على حدة.
قراءة مؤشرات الضغط PSI
/proc/pressure/cpu       some avg10=77.26 avg60=26.44 avg300=6.47 total=21187374
                         full avg10=0.00  avg60=0.00  avg300=0.00 total=0
5 s after the load ended some avg10=57.85 avg60=31.04 avg300=8.21
/proc/pressure/memory    some ...  full ...
/proc/pressure/io        some ...  full ...
كل ملف فيه سطران. some نسبة الوقت الذي انتظرت فيه مهمة واحدة على الأقل، وfull نسبة الوقت الذي انتظرت فيه كل المهام غير الخاملة معاً، أي أن العمل توقف تماماً. والمتوسطات لعشر ثوانٍ ودقيقة وخمس دقائق، وtotal مجموع تراكمي بالميكروثانية يصلح للرسوم. والسطر full للمعالج على مستوى النظام كله يبقى صفراً لأن هناك دائماً مهمة تعمل، ومعناه يظهر داخل cgroup كما سنرى. وبعد انتهاء الحمل بخمس ثوانٍ كان avg10 ما زال 57.85 لأنه يتناقص تدريجياً، فاقرأ avg10 للحاضر وavg300 للاتجاه.
الخنق بالحد cpu.max
echo "+cpu +memory" > /sys/fs/cgroup/cgroup.subtree_control
mkdir /sys/fs/cgroup/lim
echo "20000 100000" > /sys/fs/cgroup/lim/cpu.max      # 20 ms per 100 ms = 20 % of one CPU
echo $$ > /sys/fs/cgroup/lim/cgroup.procs; stress-ng --cpu 1 -t 10 --metrics-brief
#  unlimited: 18898 bogo ops, 1888.76 ops/s
#  limited:    3632 bogo ops,  363.18 ops/s
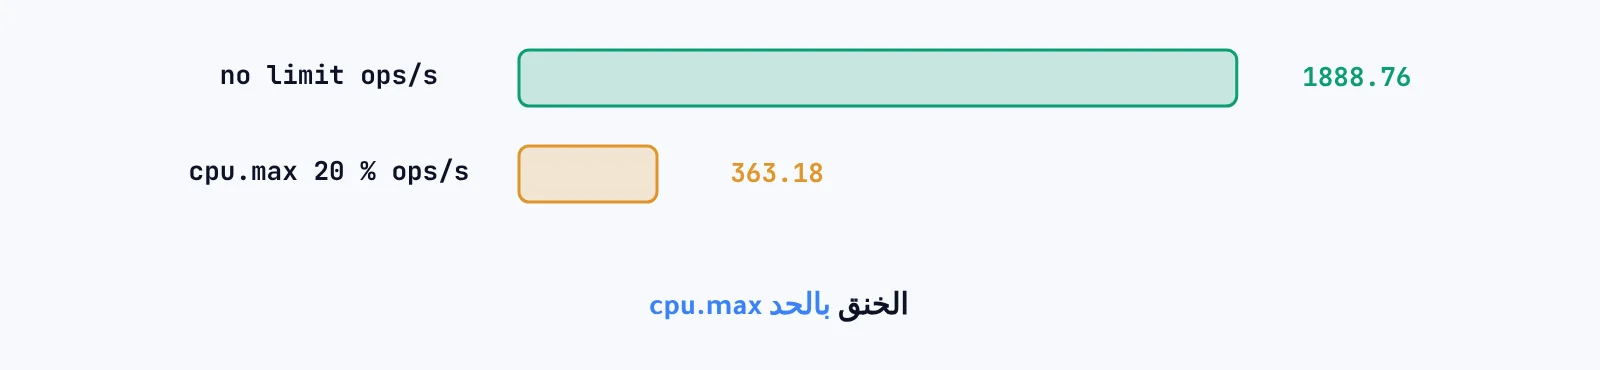
الملف cpu.max فيه رقمان: الحصة بالميكروثانية، ثم طول الفترة. فـ 20000 من 100000 تعني أن المجموعة تأخذ 20 مللي ثانية من المعالج كل 100 مللي ثانية ثم تُوقف حتى الفترة التالية. والعامل نفسه أنجز 1888 عملية في الثانية بلا حد، و363 مع الحد، أي 19.2 بالمئة، وهذا قريب جداً من الحد المطلوب. وهذا هو ما يفعله Docker بالخيار –cpus=0.2 وsystemd بالخاصية CPUQuota=20%: كلاهما يكتب في cpu.max نفسه.
cat /sys/fs/cgroup/lim/cpu.stat
usage_usec      2517109
nr_periods      127
nr_throttled    124
throttled_usec  9809217
cat /sys/fs/cgroup/lim/cpu.pressure
some avg10=53.26 ...
full avg10=53.26 ...
top: stress-ng  R  25.0 %CPU    (one sample)
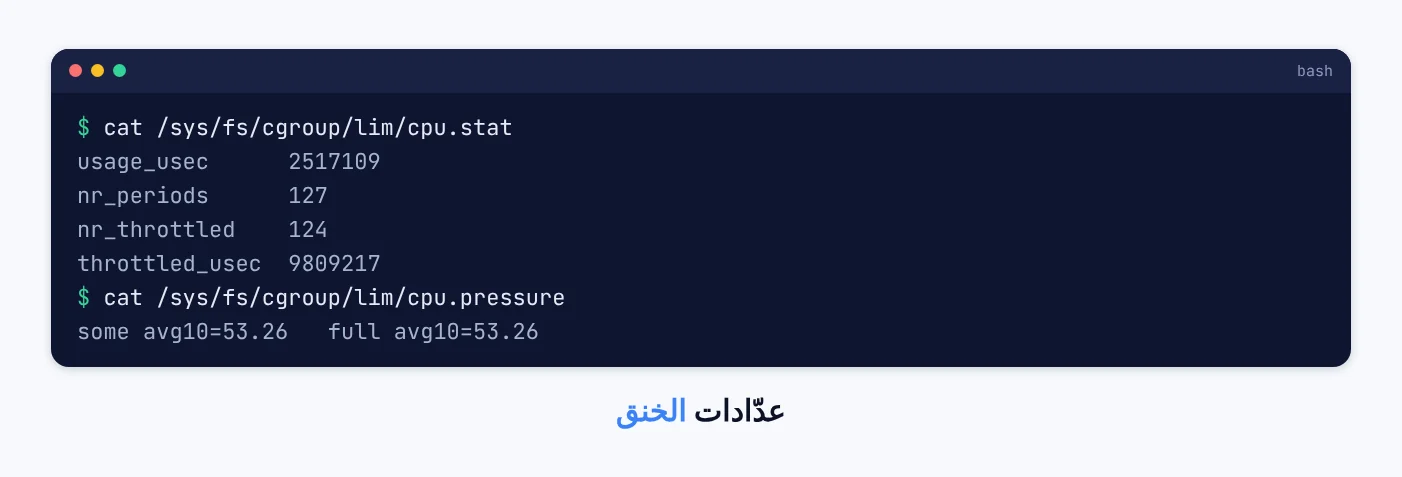
هنا الأرقام التي تكشف الخنق. من 127 فترة خُنقت المجموعة في 124، ومجموع زمن الإيقاف 9.8 ثانية من عشر. وضغط المعالج داخل المجموعة some وfull متساويان عند 53 بالمئة، لأن المجموعة فيها مهمة واحدة، فإن انتظرت انتظر الجميع. أما top فعرض لحظة واحدة بنسبة 25 بالمئة، وهي قراءة عابرة لا تخبرك أن العملية محبوسة. فإن اشتكى أحد من بطء خدمة في حاوية والمعالج غير ممتلئ، فانظر أولاً إلى nr_throttled.
الأوزان cpu.weight: نسبة لا حد
echo 300 > /sys/fs/cgroup/hi/cpu.weight     # default is 100
echo 100 > /sys/fs/cgroup/lo/cpu.weight
# two stress-ng --cpu 2 runs, one in each group, 10 s, both at once
#  hi usage_usec 15597820     lo usage_usec 5540966     ratio 2.8 : 1
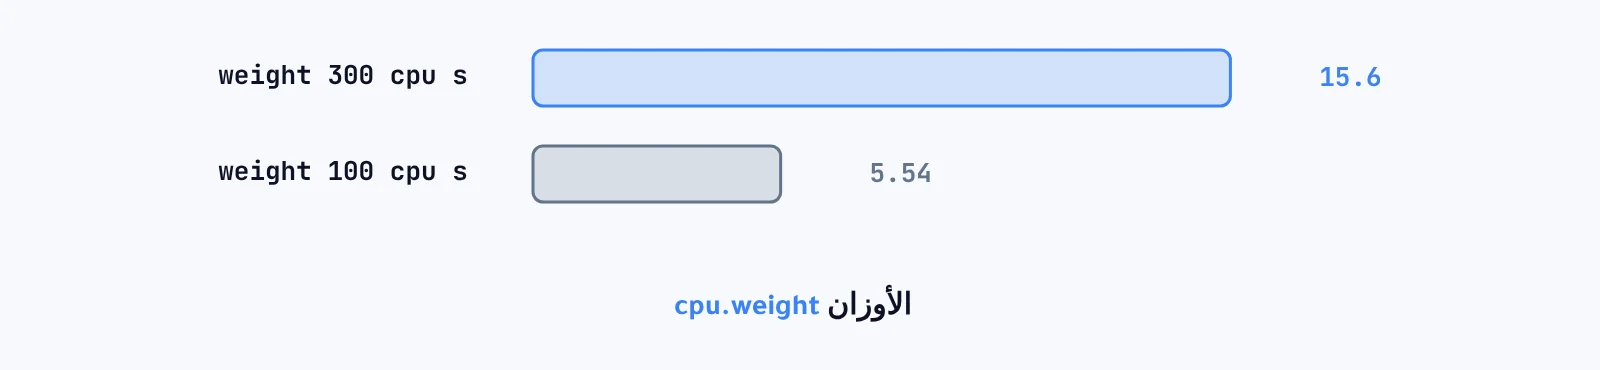
الوزن لا يحدد سقفاً، بل يقسم المعالج حين يتنافس عليه أكثر من طرف. مجموعتان كل منهما تريد المعالجين كاملين، بوزن 300 مقابل 100، فأخذت الأولى 15.6 ثانية والثانية 5.5 في عشر ثوانٍ، بنسبة قريبة من ثلاثة إلى واحد. ولو عملت مجموعة لوحدها لأخذت كل المعالج مهما كان وزنها. لذلك الوزن مناسب لحماية خدمة مهمة من مهام خلفية دون إهدار معالج فارغ، والحد cpu.max مناسب حين تريد سقفاً ثابتاً كخطة استضافة.
خنق الذاكرة بالحد memory.high
memory.high = 64M, memory.swap.max = 0
stress-ng --vm 1 --vm-bytes 48M --vm-keep -t 8    wall time 13.89 s
memory.events      low 0   high 487   max 0   oom 0   oom_kill 0
memory.pressure    some avg10=48.72   full avg10=48.72
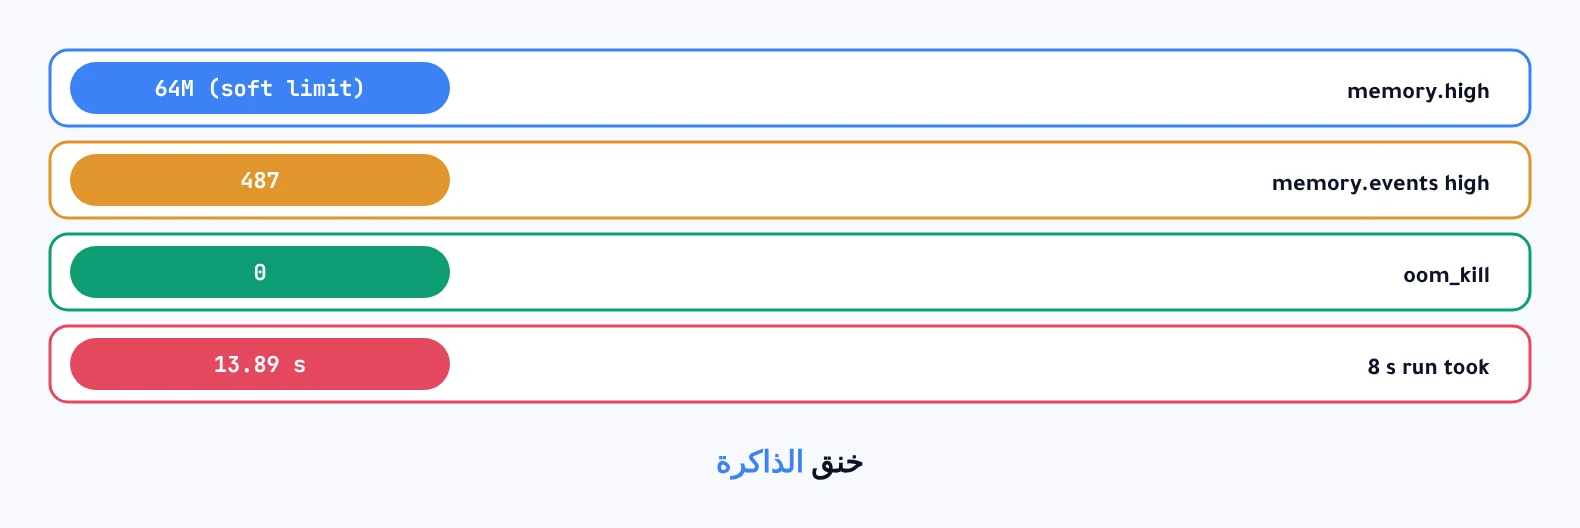
للذاكرة حدان. memory.max سقف صلب، ومن يتجاوزه داخل المجموعة يُقتل. أما memory.high فسقف لين: حين تتجاوزه المجموعة تبطئها النواة وتجبرها على استرداد صفحاتها بنفسها. عامل بحجم 48 ميغابايت مع ذاكرة stress-ng نفسها تجاوز الحد 487 مرة، ولم يُقتل، لكن تشغيلاً مدته 8 ثوانٍ انتهى بعد 13.89، وضغط الذاكرة في المجموعة بلغ 48 بالمئة. وهذه إشارة مفيدة: ضغط ذاكرة مرتفع في مجموعة مع عدّاد high يرتفع يعني أن الحد ضيق قبل أن يصل الأمر إلى القتل، وتفاصيل القتل وذاكرة التبديل swap في إدارة الذاكرة وقاتل OOM.
أين تجد هذه الأرقام في الإنتاج
systemctl show nginx -p CPUQuotaPerSecUSec -p ControlGroup
cat /sys/fs/cgroup/system.slice/nginx.service/cpu.stat        # nr_throttled
cat /sys/fs/cgroup/system.slice/nginx.service/memory.pressure
docker stats --no-stream ; docker inspect -f '{{.HostConfig.NanoCpus}}' web
# alert idea: cpu some avg60 > 40 for 5 minutes, or nr_throttled growing every minute
هذه الأوامر للتوثيق ولم تُشغّل في المختبر، لأنه بلا systemd ولا Docker. لكن الملفات نفسها التي قرأناها موجودة لكل خدمة systemd تحت مسارها في /sys/fs/cgroup، ولكل حاوية Docker. وأدوات المراقبة الحديثة مثل node_exporter تقرأ ملفات PSI، فتستطيع التنبيه على الانتظار لا على الاستخدام. ولمتابعة العمليات نفسها ومن يأخذ المعالج راجع إدارة العمليات بـ top وhtop.
أخطاء شائعة
قراءة متوسط الحمل دون قسمته
حمل 4 على أربعة معالجات طبيعي، وعلى معالجين يعني انتظاراً مستمراً.
الحكم على الخنق من top
top يعرض لحظة، والعدّاد nr_throttled يعرض التاريخ كله.
استعمال الوزن كسقف
cpu.weight لا يمنع مجموعة وحيدة من أخذ كل المعالج.
وضع memory.max بلا memory.high
بلا سقف لين تنتقل الخدمة من العمل الطبيعي إلى القتل دون إنذار.
أسئلة يطرحها الناس
هل PSI متاح على كل خادم؟
يحتاج نواة 4.20 أو أحدث مع تفعيله، وهو مفعّل افتراضياً في نواة أوبونتو التي جربنا عليها، والملفات في /proc/pressure تؤكد ذلك.
ما طول الفترة المناسب في cpu.max؟
الافتراضي 100 مللي ثانية، وفترة أقصر تقلل زمن الإيقاف المتصل للخدمات الحساسة للاستجابة مقابل كلفة جدولة أعلى.
الخلاصة
مع أربعة عمال على معالجين كان الحمل 1.63 بينما قال PSI إن 77 بالمئة من الوقت فيه انتظار. والحد 20 بالمئة أعطى 19.2 بالمئة من الأداء، وخُنقت المجموعة في 124 فترة من 127 بمجموع 9.8 ثانية. والأوزان 300 مقابل 100 قسمت المعالج 2.8 إلى واحد، وmemory.high أبطأ العامل من 8 إلى 13.89 ثانية بعد 487 تجاوزاً دون أي قتل.