التسجيل المركزي للسجلات: ELK Stack وخط نقل rsyslog مقيس
 aldawsari
التسجيل المركزي للسجلات يعني أن تصل سجلات كل سيرفراتك إلى مكان واحد، فتبحث فيها معاً، وتبقى حتى لو تعطل السيرفر الذي كتبها أو مسح المتسلل سجلاته المحلية. وحزمة ELK، أي Elasticsearch وLogstash وKibana ومعها Filebeat، هي الحل الأشهر لذلك. لكن أغلب العمل الحقيقي في أي نظام تسجيل مركزي يحدث قبل محرك البحث: كيف تُنقل السطور، وماذا يضيع حين ينقطع الخادم المركزي، وبأي صيغة تُحفظ. وفي هذا الدليل نشرح مكونات ELK وإعدادها، ونقيس خط نقل حقيقياً في المختبر بخادم rsyslog مركزي وسيرفرين يرسلان إليه: نقطع الخادم ونعد ما وصل، ونرسل دفعة من عشرين ألف سطر عبر UDP وTCP، ونقيس زمن الوصول وحجم التخزين وسرعة البحث.
نمر بمكونات ELK وما لم نشغله، والمختبر، والنقل بصيغة JSON، وانقطاع الخادم المركزي، والدفعات الكبيرة وUDP، ثم التخزين والبحث وخط ELK كاملاً.
مكونات ELK وما لم نشغله
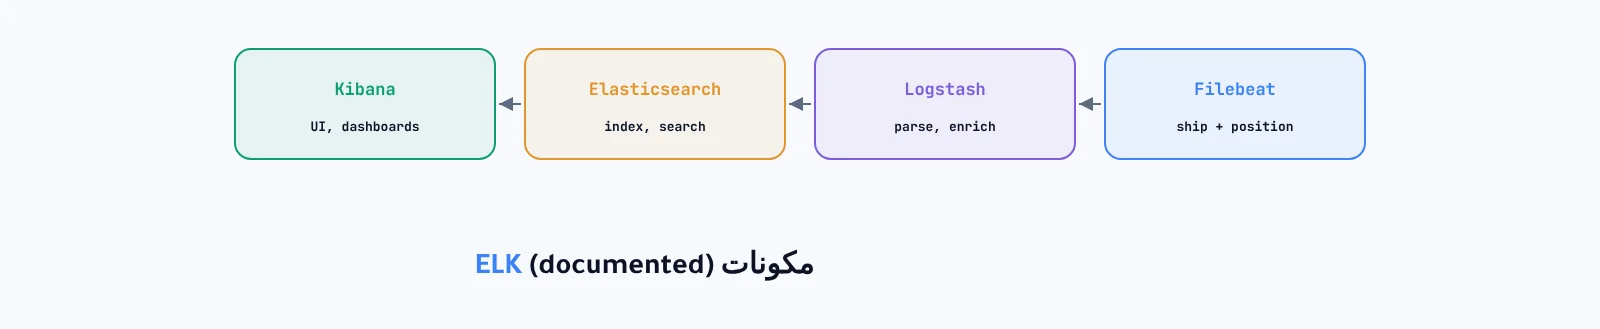
Filebeat        on every server: tails log files, ships them, remembers its position
Logstash        optional: parses lines (grok), enriches, routes
Elasticsearch   stores JSON documents in indices, full-text search
Kibana          web UI: search, dashboards, alerts
not run in this lab: no Elastic packages in the Ubuntu 24.04 archive, and the lab
cannot download from artifacts.elastic.co; Elasticsearch also wants several GB of RAM
كل مكون له دور واضح: Filebeat خفيف يقرأ الملفات ويرسلها ويتذكر أين توقف، وLogstash يحول السطر النصي إلى حقول، وElasticsearch يفهرس الحقول للبحث السريع، وKibana واجهة البحث واللوحات. ولم نستطع تشغيل هذه الحزمة في المختبر، فهي غير موجودة في مستودعات أوبونتو، والتحميل من موقع Elastic غير متاح من بيئتنا، وElasticsearch يحتاج ذاكرة أكبر مما يناسب جهازاً مشتركاً. فقسنا الطبقة التي تسبقه بأداة rsyslog الموجودة على كل توزيعة، وفي آخر الدليل إعداد خط ELK موثقاً لا مقيساً.
المختبر
rsyslogd 8.2312.0, three network namespaces on one bridge
central   10.42.0.2    imtcp :9630, imudp :9631, one JSON file per host
web1      10.42.0.11   omfwd TCP with a disk-assisted queue (tag "udp..." goes over UDP)
db1       10.42.0.12   same
# central
template(name="perhost" type="string" string="/srv/logs/%HOSTNAME%.json")
template(name="j" type="string" string="%jsonmesg%\n")
action(type="omfile" dynaFile="perhost" template="j")
# clients
action(type="omfwd" target="10.42.0.2" port="9630" protocol="tcp"
       queue.type="LinkedList" queue.filename="fwd_q" queue.saveOnShutdown="on"
       queue.maxDiskSpace="100m" action.resumeRetryCount="-1")
بنينا ثلاث مساحات شبكية على جسر واحد: خادم مركزي وسيرفر ويب وسيرفر قاعدة بيانات، ولكل منها نسخة rsyslog خاصة بإعدادها. والعميل يرسل عبر TCP بطابور في الذاكرة يتحول إلى القرص عند الحاجة، ويعيد المحاولة بلا حد. والخادم يكتب كل رسالة سطر JSON كاملاً في ملف باسم السيرفر المرسل. وفهم السجلات المحلية التي ننقلها في سجلات لينكس journalctl و/var/log.
النقل بصيغة JSON
web1: 100 x "GET /page/N 200" (info) + 10 x "upstream timed out" (err)    db1: 50 x "Aborted connection" (warning)
received:  web1.json 110 lines   db1.json 50 lines
{ "msg": " GET \/page\/1 200 rt=0.01", "hostname": "web1", "programname": "nginx",
  "syslogseverity": "6", "fromhost-ip": "10.42.0.11", "inputname": "imtcp",
  "timereported": "2026-11-15T23:15:17.648445+03:00", "timegenerated": "2026-11-15T23:15:17.653416+03:00", ... }
$ jq -r 'select((.syslogseverity|tonumber) <= 3) | .hostname' *.json | sort | uniq -c
     10 web1
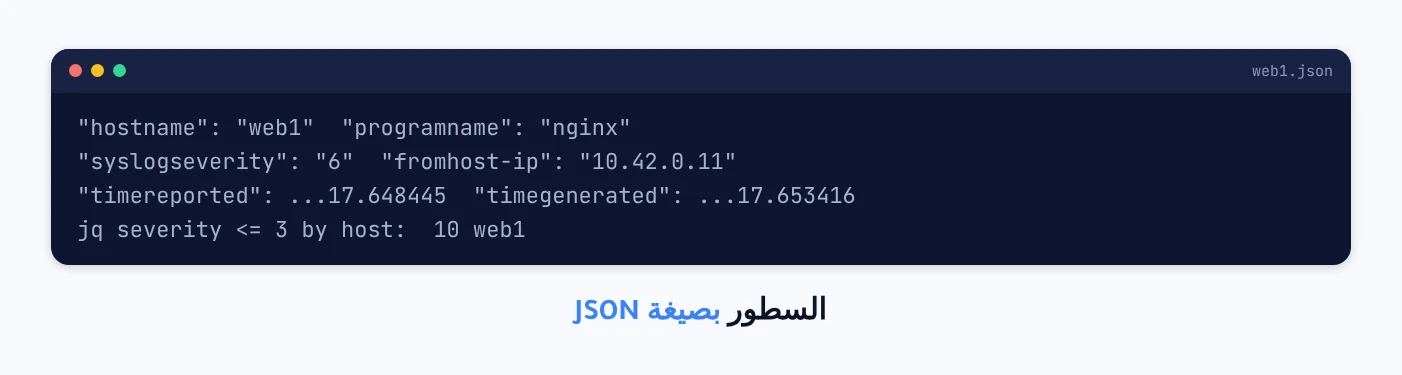
كل سطر وصل ومعه حقوله: اسم السيرفر، والبرنامج، والخطورة، وعنوان المرسل، ووقتان: وقت كتابة الرسالة على السيرفر، ووقت استلامها في المركز. والفرق بينهما هنا خمسة مللي ثوان. وبسبب الصيغة الموحدة صار البحث سؤالاً عن حقل لا تعبيراً نمطياً هشاً: الأخطاء وما فوقها جاءت كلها من سيرفر الويب، عشر رسائل. وهذا بالضبط ما يفعله Elasticsearch على نطاق أكبر، لكن الفكرة واحدة: حوّل السطر إلى حقول عند الاستلام، لا عند البحث.
انقطاع الخادم المركزي
central stopped; web1 sends 1000 messages over TCP and 1000 over UDP
client queue while waiting:          fwd_q.00000001   156,566 bytes
client restarted (saveOnShutdown):   fwd_q.00000001   459,509 bytes   fwd_q.qi 563 bytes
central started again:
TCP: 1000 of 1000 delivered within 1022 ms
UDP:    0 of 1000 delivered
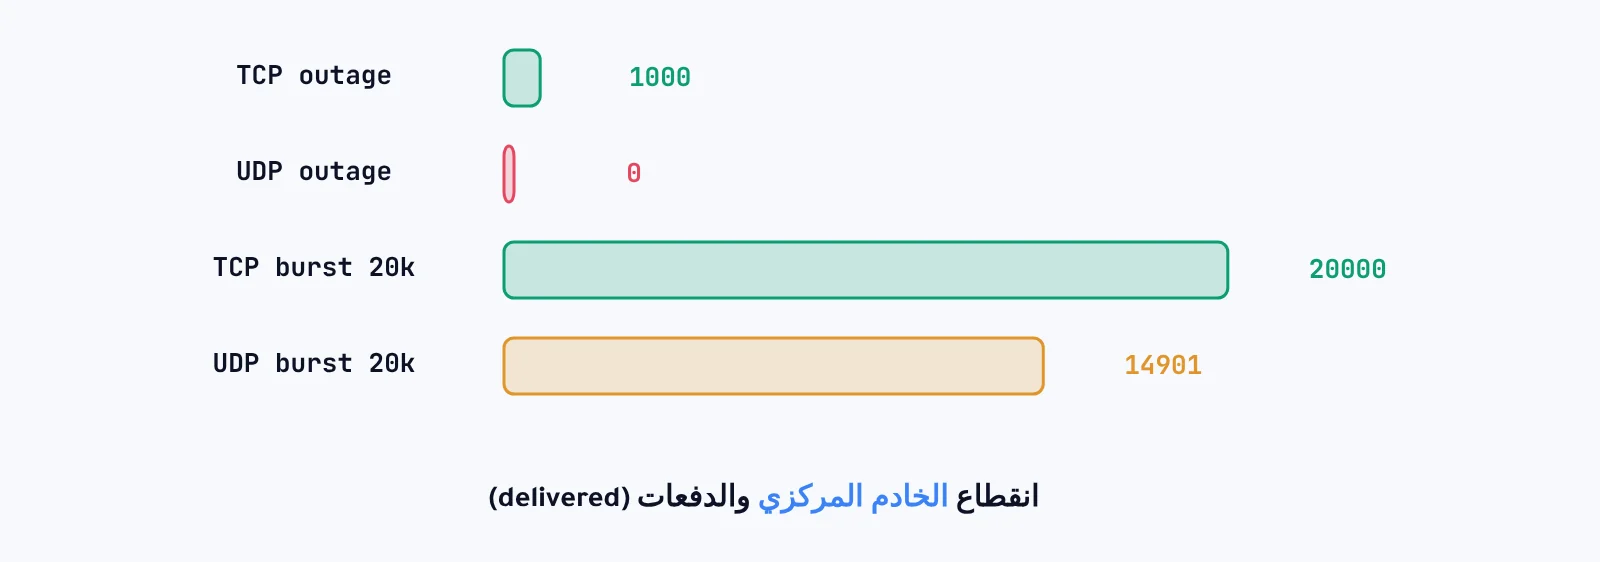
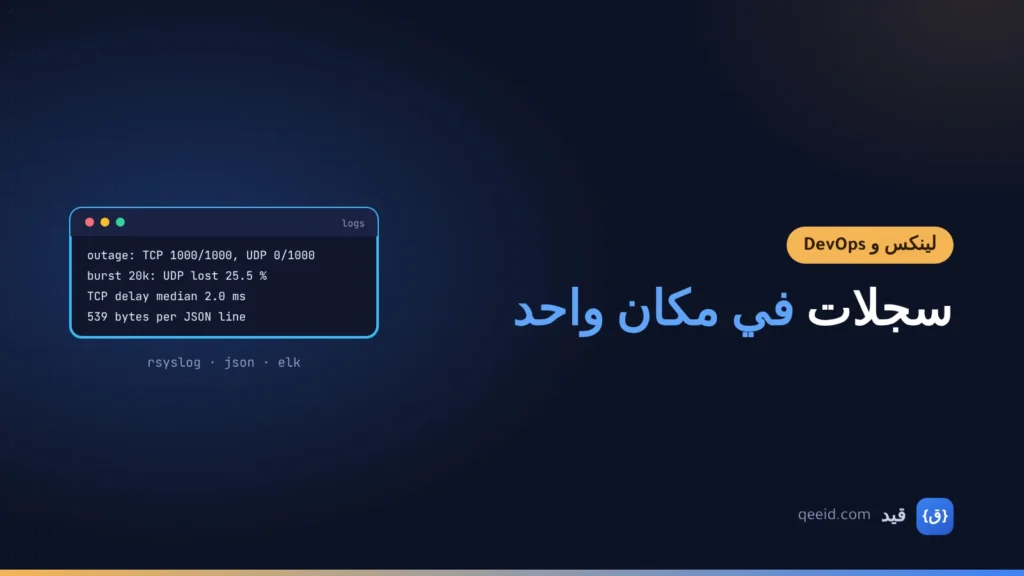
أوقفنا الخادم المركزي، فتراكمت رسائل TCP في طابور العميل، وكتبه على القرص حين أعدنا تشغيل العميل نفسه أثناء الانقطاع. وحين عاد الخادم وصلت الرسائل الألف كلها خلال ثانية. أما رسائل UDP فضاعت كلها، فالعميل يرسلها ولا يعرف أن أحداً لا يستمع. وهذا الفرق هو ما يجعل طبقة النقل أهم من محرك البحث: سجلات لحظة العطل هي التي تحتاجها، وهي بالضبط ما يضيع إن كان النقل بلا طابور. ويؤدي Filebeat الدور نفسه بحفظ موضعه في الملف، فيكمل القراءة من حيث توقف.
الدفعات الكبيرة وUDP
server up, 20,000 lines sent in one burst from each client
TCP (web1):   20,000 received
UDP (db1):    14,901 received    5,099 lost (25.5 %)
delivery delay over TCP (timegenerated - timereported), 20,000 lines:
median 2.0 ms    p99 5.4 ms    max 6.2 ms
حتى والخادم يعمل، أضاعت دفعة UDP ربع رسائلها، لأن ذاكرة الاستقبال امتلأت أسرع مما يقرأ الخادم، وUDP لا يعيد شيئاً. ودفعة TCP وصلت كاملة بزمن وسيط مللي ثانيتين. والدفعات ليست نظرية: سيرفر في مشكلة يكتب آلاف الأخطاء في ثوان، وهذه أهم اللحظات. فاستخدم TCP دائماً بين السيرفرات، وأضف TLS إن مرت السجلات على شبكة لا تثق بها.
التخزين والبحث وخط ELK
web1.json: 20,000 lines = 10,777,788 bytes  (539 bytes per line, message itself ~15 chars)
grep -c over 34,901 lines        12 ms
jq select over 34,901 lines     278 ms
# ELK pipeline, documented (not run here)
# filebeat.yml
filebeat.inputs:
  - type: filestream
    id: nginx
    paths: [ /var/log/nginx/access.log ]
output.logstash: { hosts: [ "logs.internal:5044" ] }
# logstash pipeline
input  { beats { port => 5044 } }
filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}" } } }
output { elasticsearch { hosts => [ "http://localhost:9200" ] index => "nginx-%{+YYYY.MM.dd}" } }
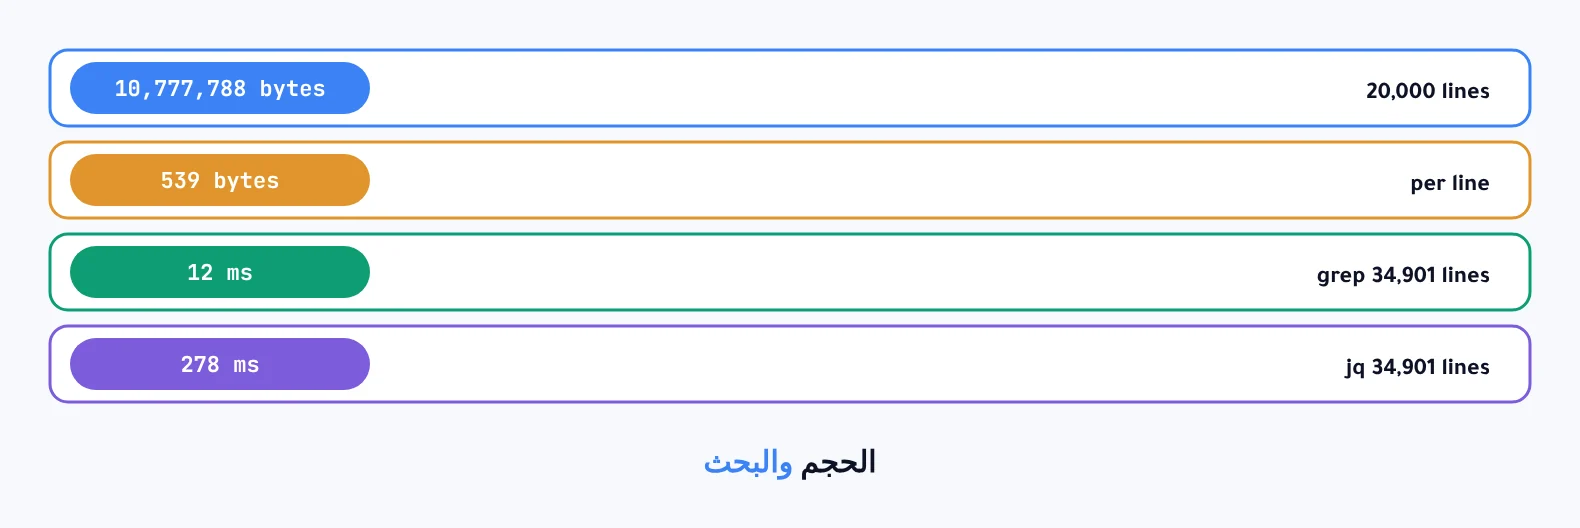
الصيغة الكاملة لها ثمن: كل سطر صار 539 بايتاً لرسالة قصيرة، لأن الحقول ووقتين وعنوانين تتكرر مع كل سطر. فاحذف الحقول التي لا تبحث فيها، وضع سياسة حذف للفهارس القديمة من اليوم الأول، فالسجلات تملأ القرص بصمت. والبحث بـ grep في 35 ألف سطر استغرق 12 مللي ثانية، وبـ jq الذي يحلل كل سطر 278 مللي ثانية. وهذا يكفي لسيرفرات قليلة. وحين تصل إلى ملايين الأسطر يومياً، أو تحتاج لوحات وتنبيهات، يأتي دور Elasticsearch وKibana بالخط الموثق أعلاه. والتنبيه على المقاييس بدل السجلات في مراقبة الأنظمة بـ Prometheus وGrafana.
أخطاء شائعة
النقل عبر UDP
ضاع ربع الدفعة وكل ما أُرسل أثناء الانقطاع.
طابور في الذاكرة فقط
إعادة تشغيل العميل تمسح ما لم يُرسل، فاحفظه على القرص.
بلا سياسة حذف
سطر من 539 بايتاً يتضاعف بسرعة.
Elasticsearch مكشوف على الإنترنت
اجعله على شبكة داخلية مع مصادقة.
أسئلة يطرحها الناس
هل أحتاج Logstash؟
ليس دائماً، فـ Filebeat يرسل إلى Elasticsearch مباشرة ويحلل الصيغ الشائعة بوحداته الجاهزة.
ما البديل الأخف من ELK؟
rsyslog إلى ملفات JSON كما قسنا لسيرفرات قليلة، أو Loki مع Grafana حين تريد واجهة بحث دون فهرسة كاملة.
الخلاصة
لم نشغل ELK لغياب حزمه عن المختبر، وقسنا طبقة النقل. فوصلت 1000 رسالة TCP كاملة خلال ثانية بعد انقطاع الخادم المركزي وضاعت الألف عبر UDP، ووصلت دفعة 20 ألف سطر عبر TCP كاملة بزمن وسيط مللي ثانيتين وأضاع UDP منها 25.5%. وكلف السطر 539 بايتاً بصيغة JSON، والبحث في 35 ألف سطر بين 12 و278 مللي ثانية.