مراقبة الأنظمة بـ Prometheus وGrafana: المقاييس والتنبيهات بتوقيت حقيقي
 aldawsari
مراقبة الأنظمة بـ Prometheus وGrafana تقوم على فكرة بسيطة: كل سيرفر وكل تطبيق يعرض أرقامه على صفحة نصية، وPrometheus يجمعها كل بضع ثوان ويحفظها سلاسل زمنية، ثم تسألها بلغة PromQL وترسم الإجابة في Grafana وتنبه حين تتجاوز حداً. والسؤال الذي يغفل عنه كثيرون: بعد كم ثانية من بدء المشكلة يصلك التنبيه، ولماذا؟ وفي هذا الدليل نشغل Prometheus وnode_exporter من حزم أوبونتو في المختبر، ونكتب تطبيقاً صغيراً يعرض عداد طلبات وتوزيع زمن الاستجابة، ثم نرسل إليه حركة منتظمة ونحقن فيها أخطاء ثم بطئاً ثم نوقفه، ونسجل بالثانية متى صار كل تنبيه معلقاً ومتى أُطلق ومتى انطفأ.
نمر بالمكونات وما شغلناه، وصفحة المقاييس، والتطبيق ومقاييسه، وقواعد التنبيه وتوقيتها، وتوقف الخدمة، ثم Grafana والكلفة.
المكونات وما شغلناه
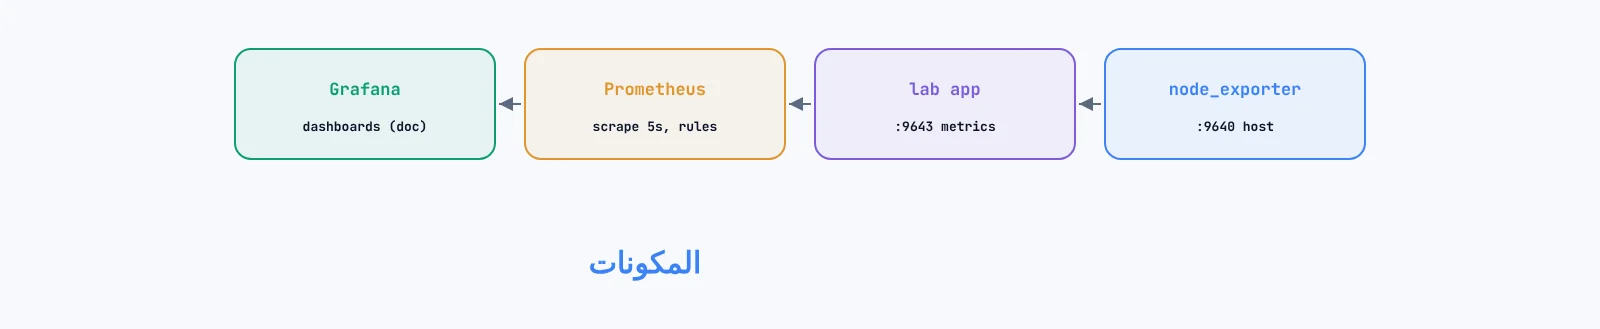
prometheus 2.45.3+ds  and  node_exporter 1.7.0   (Ubuntu 24.04 packages, binaries extracted to the lab)
node_exporter   127.0.0.1:9640   host metrics
lab app         127.0.0.1:9642   web app, its own metrics on :9643 (python prometheus_client)
prometheus      127.0.0.1:9641   scrape_interval 5s, evaluation_interval 5s, 3 alert rules
grafana         not run: not in the Ubuntu archive, and the lab cannot reach grafana.com
$ promtool check config prometheus.yml   ->  SUCCESS: 3 rules found
Prometheus يسحب المقاييس بنفسه من كل هدف، ولا ينتظر أن ترسل إليه، فيعرف فوراً إن غاب هدف. وnode_exporter يعرض مقاييس الجهاز، والتطبيقات تعرض مقاييسها بمكتبة لكل لغة. وGrafana واجهة الرسوم، ولم نستطع تشغيلها لأنها ليست في مستودعات أوبونتو ولا يصل المختبر إلى موقعها، فاستخدمنا واجهة Prometheus البرمجية للاستعلام، وهي نفسها ما تستدعيه Grafana في كل لوحة. وفحص الإعداد بأداة promtool قبل التشغيل يوفر عليك خطأ مسافة في YAML يوقف كل شيء.
صفحة المقاييس
$ curl -s 127.0.0.1:9640/metrics | grep -vc '^#'
345                                  # 8 collectors enabled: cpu meminfo loadavg filesystem netdev diskstats stat uname
35601 bytes in 0.002 s
targets:  node up  lastScrapeDuration 0.0072 s      app up  0.0018 s
node_memory_MemAvailable_bytes, node_cpu_seconds_total{cpu="0",mode="idle"}, node_load1 ...
100 * (1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)   ->  14.3
صفحة node_exporter نص عادي، كل سطر اسم مقياس ووسومه وقيمته. وفعّلنا ثماني مجموعات فقط، فكانت 345 قيمة بحجم 35 كيلوبايت، وجمعها Prometheus في 7 مللي ثوان. والقيم الخام نادراً ما تُعرض كما هي: الذاكرة المستخدمة مثلاً معادلة بين مقياسين، وكانت 14.3% لحظة السؤال. وزمن المعالج عداد يتزايد منذ الإقلاع، فلا معنى له إلا بالدالة rate التي تحسب معدل تغيره في نافذة زمنية.
التطبيق ومقاييسه
REQ = Counter('lab_http_requests_total', 'requests', ['path', 'code'])
LAT = Histogram('lab_http_request_seconds', 'latency', ['path'],
                buckets=(.005, .01, .025, .05, .1, .25, .5, 1))
# in the handler: REQ.labels(path, code).inc(); LAT.labels(path).observe(elapsed)
load: about 20 requests/s for 230 s:  normal 60 s | 10% errors 45 s | normal 40 s | 30% slow (+0.2 s) 45 s | normal 40 s
sum(rate(lab_http_requests_total[30s]))                     19.8 req/s
error ratio (5xx / all, 30s)                                peak 0.091
histogram_quantile(0.95, ... lab_http_request_seconds ...)  normal 0.024 s, slow phase 0.214 - 0.226 s
histogram_quantile(0.50, ...)                               normal 0.011 s, slow phase 0.0176 s max
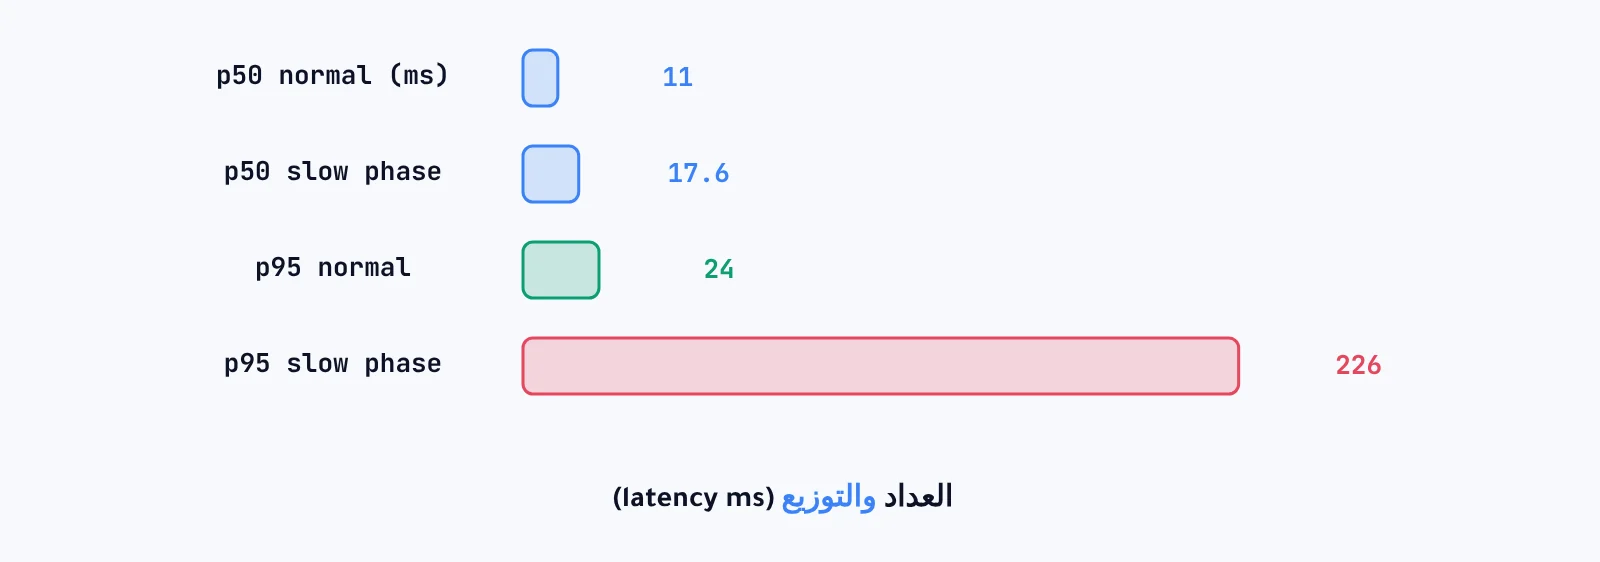
عداد الطلبات بوسمين، المسار ورمز الرد، يكفي لحساب المعدل ونسبة الأخطاء. والتوزيع Histogram يعد الطلبات في سلال زمنية، ومنه نحسب الشرائح المئوية. والنتائج طابقت ما حقناه: نحو عشرين طلباً في الثانية، ونسبة أخطاء بلغت 9.1% حين جعلنا عُشر الطلبات تفشل. لكن انظر إلى الشريحة 95 في الوضع العادي: 0.024 ثانية ثابتة تقريباً، لأن الحساب يقدّر القيمة داخل السلة بين 0.01 و0.025، فدقة الرقم من دقة السلال التي اخترتها. وحين صار ثلث الطلبات بطيئاً قفزت الشريحة 95 إلى أكثر من 0.2 ثانية، بينما تحركت الوسيطة قليلاً فقط، ولهذا يراقب الناس الشرائح العليا لا المتوسط.
قواعد التنبيه وتوقيتها
- alert: HighErrorRate
  expr: sum(rate(lab_http_requests_total{code=~"5.."}[30s])) / sum(rate(lab_http_requests_total[30s])) > 0.05
  for: 10s
- alert: SlowP95
  expr: histogram_quantile(0.95, sum by (le) (rate(lab_http_request_seconds_bucket[30s]))) > 0.1
  for: 10s
t=  60.0s  errors start         t=  82.7s HighErrorRate pending     t=  92.7s firing
t= 105.1s  errors stop          t= 122.8s HighErrorRate inactive
t= 145.1s  slowness starts      t= 157.3s SlowP95 pending           t= 167.4s firing
t= 190.1s  slowness stops       t= 217.5s SlowP95 inactive
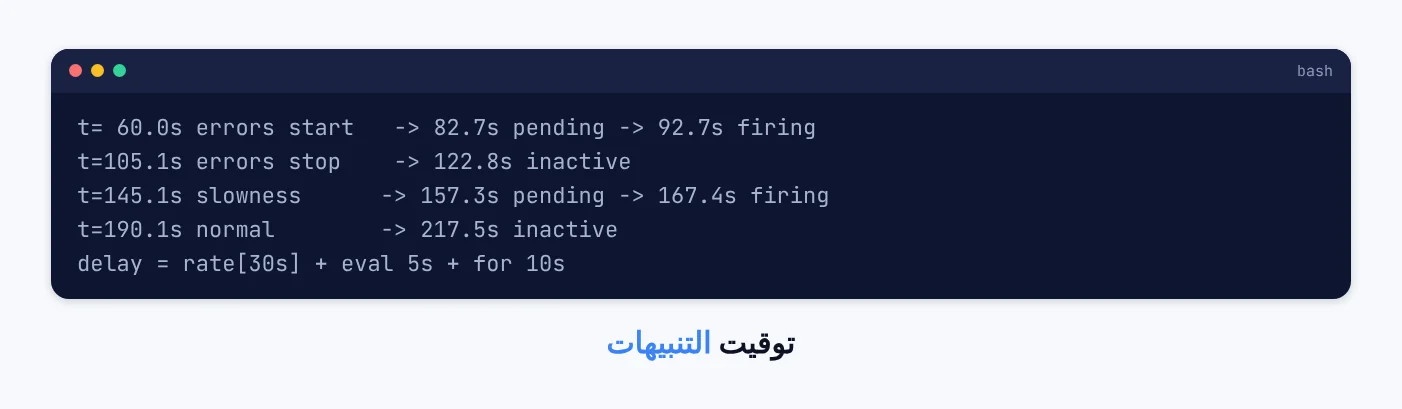
بدأت الأخطاء في الثانية 60، وأُطلق التنبيه في الثانية 92.7، أي بعد نحو 33 ثانية. وهذا التأخير مصنوع من ثلاثة أجزاء: نافذة rate بطول 30 ثانية يجب أن تمتلئ بما يكفي من الأخطاء لتتجاوز النسبة 5%، ثم دورة تقييم كل 5 ثوان، ثم شرط for الذي يطلب بقاء الحالة 10 ثوان قبل الإطلاق. وانطفأ التنبيه بعد 18 ثانية من توقف الأخطاء، حين خرجت من النافذة. والبطء اكتُشف أسرع، في 22 ثانية، لأن قفزته أكبر بكثير من الحد. فالقاعدة: النافذة الأقصر وfor الأقصر تكشفان أسرع، لكنهما تطلقان تنبيهات على قفزات عابرة، والتوازن يحدده كم دقيقة تتحمل خدمتك.
توقف الخدمة
- alert: InstanceDown
  expr: up == 0
  for: 15s
t=  0.0s   app process killed
t=  4.5s   up{job="app"} = 0         (next scrape failed)
t=  6.5s   InstanceDown pending
t= 21.6s   InstanceDown firing
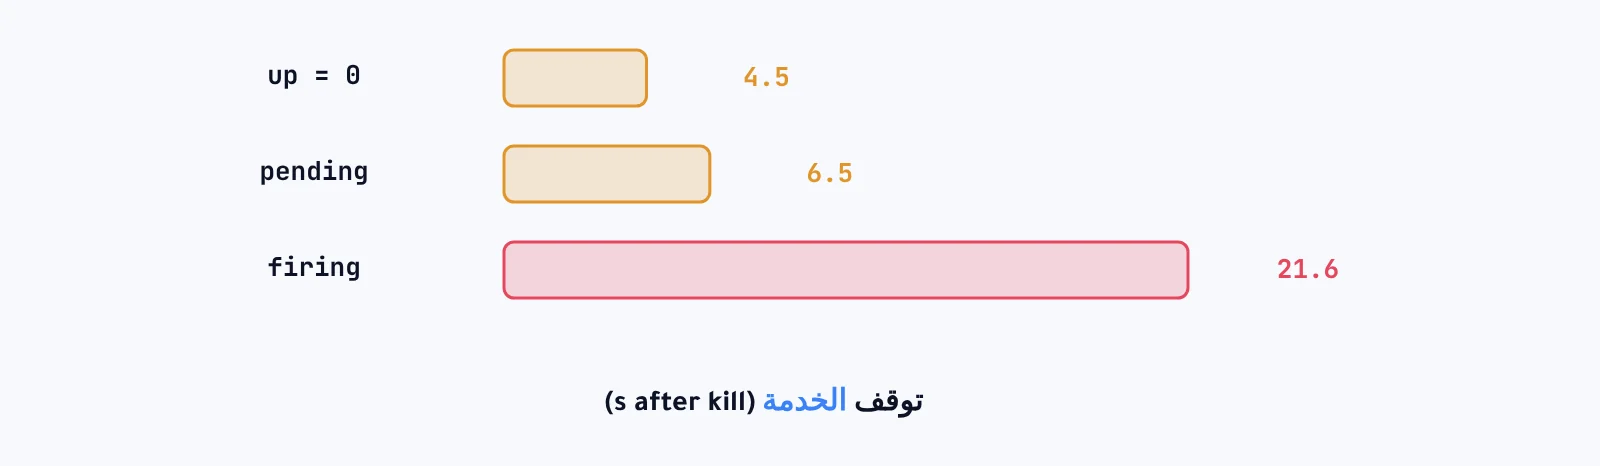
المقياس up يضيفه Prometheus بنفسه لكل هدف: واحد إن نجح السحب وصفر إن فشل. أوقفنا التطبيق، فصار صفراً بعد 4.5 ثانية مع أول سحب فاشل، وصار التنبيه معلقاً بعد ثانيتين في دورة التقييم التالية، ثم أُطلق بعد 15 ثانية بالضبط. وهذا التنبيه أهم من كل ما سواه، لأن الهدف الذي لا يُسحب لا تصل مقاييسه أصلاً، فلا يطلق أي تنبيه آخر. ويوصل Alertmanager التنبيه إلى البريد أو تيليجرام أو غيرهما، ويجمع التنبيهات المتشابهة، ولم نشغله هنا. وسجلات الخدمة نفسها، لتعرف لماذا توقفت، يجمعها خط آخر كما في التسجيل المركزي للسجلات.
Grafana والكلفة
# /etc/grafana/provisioning/datasources/prometheus.yml   (documented, not run here)
apiVersion: 1
datasources:
  - name: Prometheus
    type: prometheus
    url: http://127.0.0.1:9090
    isDefault: true
measured cost after the run:  prometheus RSS 51 MB,  node_exporter RSS 20 MB,  data dir 232 KB
في Grafana تضيف Prometheus مصدراً للبيانات، ثم تكتب في كل لوحة الاستعلام نفسه الذي جربناه بالواجهة البرمجية. والإعداد بالملف أعلاه أفضل من النقر في الواجهة، لأنه يُحفظ في git ويُعاد بناؤه. والكلفة صغيرة: Prometheus استخدم 51 ميغابايت من الذاكرة، وnode_exporter عشرين. والحجم على القرص يكبر مع عدد السلاسل ومدة الحفظ، فراقب عدد الوسوم، ولا تضع في وسم قيمة لا تنتهي مثل رقم المستخدم أو الرابط الكامل. وتخفيف ضغط المعالج والذاكرة الذي تكشفه هذه اللوحات مشروح في مراقبة المعالج والذاكرة في لينكس.
أخطاء شائعة
تنبيه بلا for
كل قفزة لحظية توقظك ليلاً.
نسيان تنبيه up == 0
الهدف الميت لا يطلق أي تنبيه آخر.
وسوم بقيم لا تنتهي
كل قيمة سلسلة جديدة تأكل الذاكرة.
مراقبة المتوسط وحده
البطء ظهر في الشريحة 95 قبل الوسيطة بكثير.
أسئلة يطرحها الناس
كم مدة الحفظ المناسبة؟
الافتراضي خمسة عشر يوماً كما تقول تعليمات prometheus –help، ويُغير بالخيار storage.tsdb.retention.time، وللحفظ الطويل يُرسل Prometheus نسخة إلى تخزين خارجي.
هل أحتاج Grafana؟
للتنبيهات لا، فهي في Prometheus. وللوحات التي يقرؤها الفريق نعم، فواجهة Prometheus للتجريب لا للعرض.
الخلاصة
جمع Prometheus 345 قيمة من node_exporter في 7 مللي ثوان، وقاس التطبيق بنحو 20 طلباً في الثانية. وأُطلق تنبيه الأخطاء بعد 33 ثانية من بدئها بنسبة بلغت 9.1%، وتنبيه البطء بعد 22 ثانية حين قفزت الشريحة 95 من 0.024 إلى 0.22 ثانية، وتنبيه التوقف بعد 21.6 ثانية. واستخدم Prometheus 51 ميغابايت من الذاكرة.