أداء Ansible على عشرات الخوادم: forks والحقائق وpipelining والتحديث المتدرج
 aldawsari
أداء Ansible يصبح مشكلة حقيقية حين يزيد عدد الخوادم: Playbook ينتهي في ثوانٍ على خادمين قد يأخذ عشرين دقيقة على مئتين، وتحديث خاطئ يُطبق على كل الخوادم معاً قد يوقف الخدمة كلها. وفي هذا الدليل نقيس ذلك بأنفسنا: Ansible 2.22 يتحكم في عشرين خادماً عبر SSH، كل خادم عنوان مستقل على المختبر، ونغير الإعدادات التي تؤثر في السرعة واحداً بعد الآخر: عدد العمليات المتوازية forks، وجمع الحقائق، وpipelining، وتعدد الاتصال في SSH، واستراتيجية التنفيذ، ثم نجرب التحديث المتدرج serial وكيف يوقف نشراً فاشلاً قبل أن يصل إلى بقية الخوادم.
نمر بالمختبر وحدوده، وبعدد العمليات المتوازية، وبكلفة جمع الحقائق وتخزينها، وبـ pipelining وتعدد الاتصال، وباستراتيجية free مقابل linear، ثم بالتحديث المتدرج ونتيجته.
المختبر وحدوده
python3 -m venv venv && venv/bin/pip install ansible-core   # ansible [core 2.22.0], 49 MB
# 20 inventory hosts web01..web20 -> 127.0.1.1 .. 127.0.1.20, port 9655
# two sshd instances (one sshd accepts at most 16 listen sockets)
ansible web -m ping -o      # 20 x SUCCESS "pong"
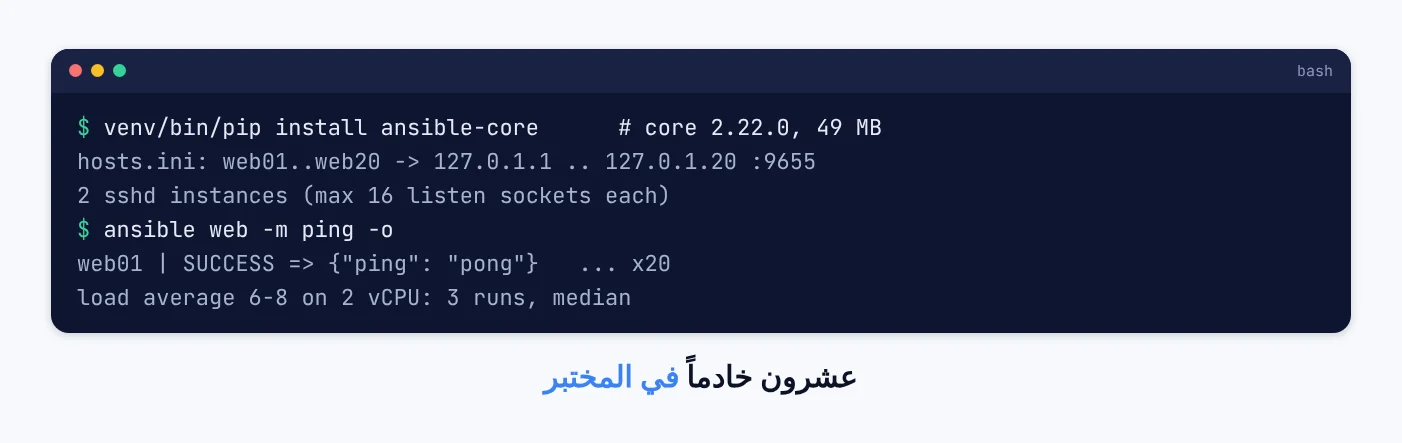
الخوادم العشرون عناوين مختلفة على الجهاز نفسه، فلكل منها اتصال SSH مستقل كما في الواقع، لكنها تتقاسم معالجين فقط مع جهاز التحكم نفسه، وكان الجهاز مشغولاً بأعمال أخرى بمتوسط حمل بين 6 و8 أثناء القياس. ولذلك نكرر كل قياس ثلاث مرات ونأخذ الوسيط، ونهتم بالنسبة بين الأرقام لا بقيمتها المطلقة. وفي شبكة حقيقية يضاف زمن الشبكة لكل اتصال، فتكبر الفروق التي نقيسها هنا ولا تصغر. وأساس تأمين SSH على الخوادم في تأمين المنافذ وSSH.
عدد العمليات المتوازية forks
ansible web -m ping -f N      (20 hosts, 3 runs each)
forks   runs (s)               median
1       11.07  14.00  17.81    14.00 s
5        8.49   8.23   7.45     8.23 s
20       5.93   4.80   4.93     4.93 s
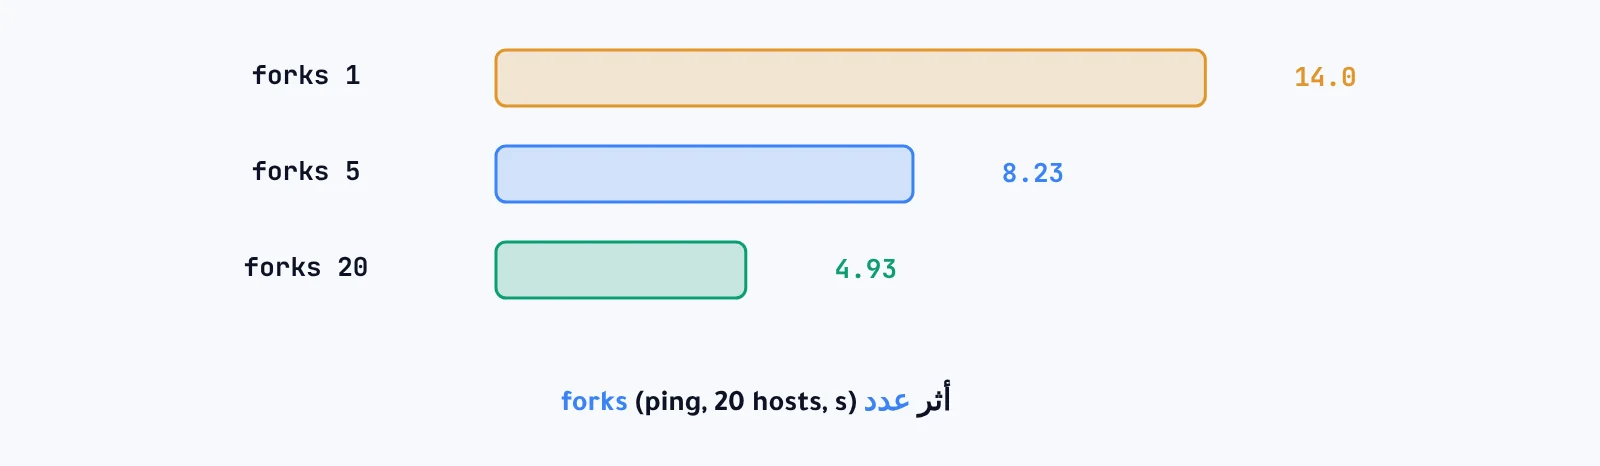
القيمة الافتراضية لـ forks خمس، أي أن Ansible يعمل على خمسة خوادم في الوقت نفسه ثم ينتقل إلى الخمسة التالية. ورفعها من 1 إلى 20 قلل الزمن من 14 ثانية إلى 4.9، لكن ليس عشرين ضعفاً، لأن كل عملية متوازية تستهلك معالجاً وذاكرة على جهاز التحكم، ومعالجانا كانا مشبعين. والقاعدة العملية: ارفع forks حتى يقترب جهاز التحكم من التشبع ولا تتجاوزه، فقيمة 50 على جهاز بمعالجين لن تكون أسرع من 20.
كلفة جمع الحقائق وتخزينها
playbook: copy one file to 20 hosts, forks 5     runs (s)              median
gather_facts: true                               24.64  25.64  34.59   25.64 s
gather_facts: false                              16.19  12.00  12.67   12.67 s
fact cache (jsonfile, gathering=smart) run 1     32.57 s   (cache empty)
fact cache (jsonfile, gathering=smart) run 2     12.29 s   (20 hosts cached)
جمع الحقائق، أي معلومات النظام والشبكة والأقراص، يجري افتراضياً في بداية كل Play، وكان يكلف نحو نصف زمن التشغيل: من 12.7 ثانية إلى 25.6. فإن لم تستخدم متغيرات مثل ansible_distribution فعطله بـ gather_facts: false. وإن احتجتها، فخزنها: مع ذاكرة الحقائق في ملفات JSON وسياسة smart، جمع التشغيل الأول حقائق الخوادم العشرين، والثاني قرأها من الملفات فنزل إلى 12.3 ثانية كأنها معطلة.
pipelining وتعدد الاتصال في SSH
same playbook, gather_facts false, forks 5                 median
default (ControlPersist=60s, pipelining off)               12.67 s
pipelining = True                                          10.77 s
ControlMaster=no (new SSH connection per task step)        36.15 s
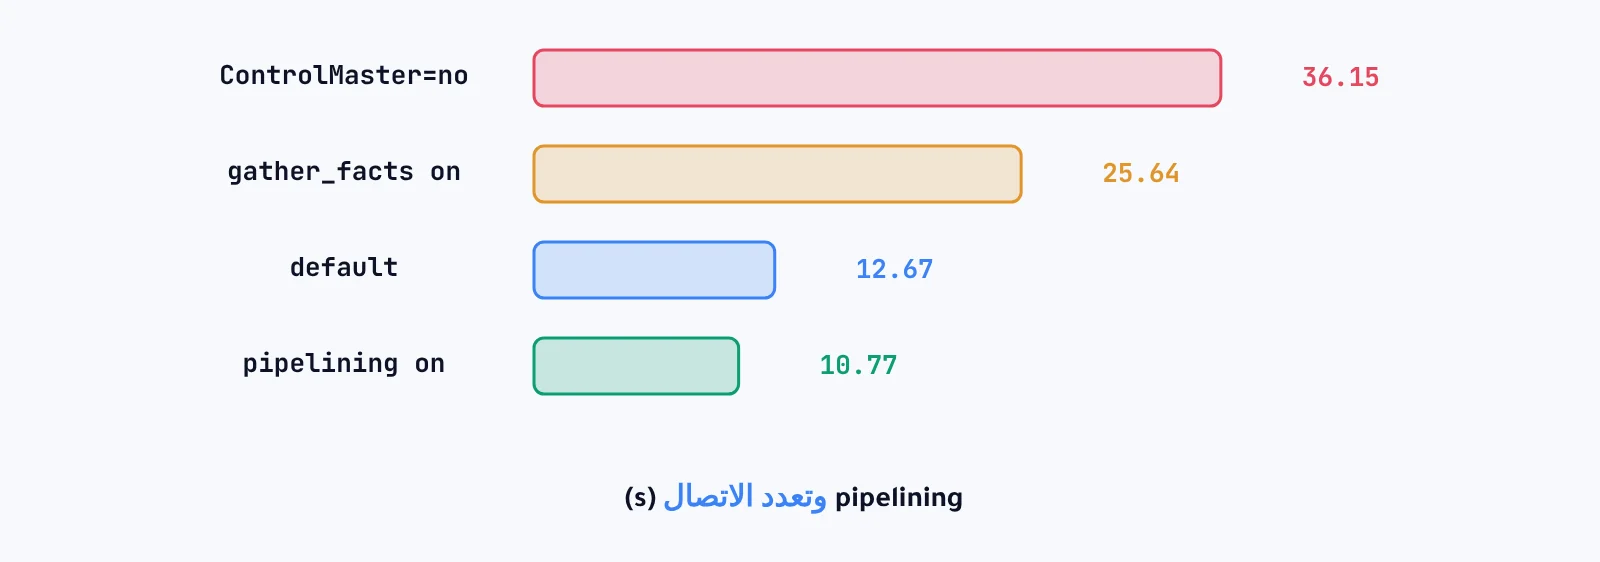
لكل مهمة ينسخ Ansible ملف الوحدة إلى الخادم ثم يشغله ثم يحذفه، وهذه ثلاثة أوامر SSH. ومع pipelining يرسل الوحدة عبر الاتصال نفسه دون ملف، فنزل الزمن 15 في المئة. أما تعدد الاتصال فأهم: الإعداد الافتراضي يبقي اتصال SSH مفتوحاً 60 ثانية ويعيد استخدامه، وحين عطلناه صار كل أمر يفتح اتصالاً جديداً بمصافحة تشفير كاملة، فتضاعف الزمن قرابة ثلاث مرات إلى 36 ثانية. ولا تعطله أبداً بإعداد ssh_args مخصص تنسى فيه ControlPersist. وتنبيه: pipelining يحتاج تعطيل requiretty في sudoers إن كانت مفعلة.
استراتيجية free مقابل linear
5 hosts, 3 tasks; in each task one different host sleeps 3 s
strategy   run 1     run 2
linear     15.33 s   14.25 s     # every task waits for the slowest host
free        7.70 s   10.65 s     # each host moves on as soon as it finishes
في الاستراتيجية الافتراضية linear تنتظر كل مهمة أبطأ خادم قبل أن تبدأ المهمة التالية على الجميع، فثلاثة خوادم بطيئة في ثلاث مهام تجمع ثلاثة انتظارات. ومع free يكمل كل خادم مهامه بسرعته، فنزل الزمن إلى النصف في التشغيل الأول وإلى ثلاثة أرباعه في الثاني. لكن free تجعل ترتيب المخرجات مختلطاً، ولا تصلح حين تعتمد مهمة على أن كل الخوادم أنهت المهمة السابقة، كإضافة الخوادم إلى موزع الأحمال بعد تحديثها كلها.
التحديث المتدرج serial
- hosts: web
  serial: [1, 5, "50%"]        # batch 1: 1 host, batch 2: 5 hosts, then 50%
  max_fail_percentage: 0       # any failure stops the remaining batches
  tasks:
    - name: deploy v2           # web04 fails its health check in the lab
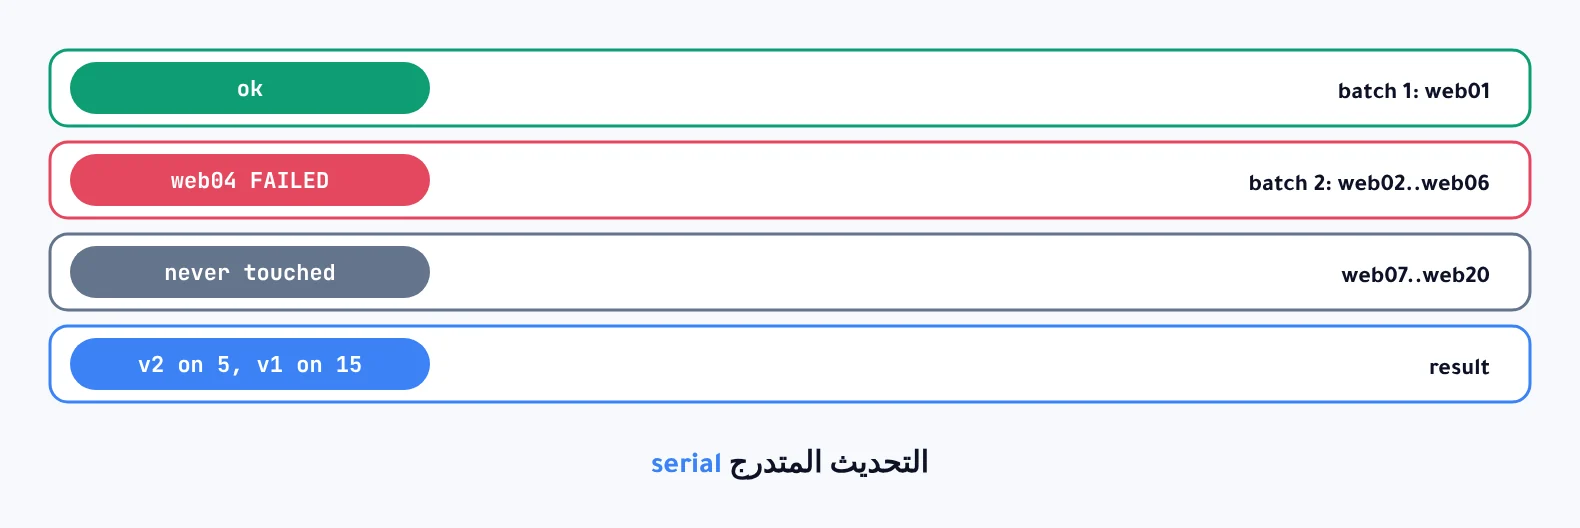
batch 1: web01                    ok
batch 2: web02 web03 web04 web05 web06   web04 FAILED ("health check failed")
NO MORE HOSTS LEFT
result: v2 on 5 hosts, v1 still on 15 hosts (web07..web20 never touched)
هذا أهم إعداد في هذا الدليل لأنه يحمي الخدمة لا الوقت. يبدأ التحديث بخادم واحد، كأنه كناري يُختبر عليه، ثم خمسة، ثم نصف الباقي. وحين فشل فحص الصحة على web04 في الدفعة الثانية، أوقف max_fail_percentage بقية الدفعات، فبقيت 14 خادماً لم تُلمس على النسخة القديمة، ولم تذهب الخدمة كلها. وأضف قبل كل دفعة مهمة تخرج الخوادم من موزع الأحمال، وبعدها مهمة تعيدها، مع delegate_to إلى خادم الموزع. ومعنى الأتمتة وخطوط النشر في ما هي DevOps والأتمتة.
أخطاء شائعة
رفع forks على جهاز تحكم صغير
بعد التشبع لا يزيد شيء إلا الحمل.
جمع الحقائق دون حاجة
كان يكلف نصف زمن التشغيل.
ssh_args مخصص بلا ControlPersist
تضاعف الزمن قرابة ثلاث مرات.
تحديث كل الخوادم في دفعة واحدة
خطأ واحد يصيب الخدمة كلها، وserial يحصره.
أسئلة يطرحها الناس
هل Mitogen ما زال مفيداً؟
يسرع Ansible كثيراً لكنه يتأخر في دعم الإصدارات الجديدة، فجربه على إصدارك قبل الاعتماد عليه.
متى أستخدم async؟
للمهام الطويلة كالتحديثات الكبيرة، حتى لا تبقى الاتصالات معلقة طوال التنفيذ.
الخلاصة
على عشرين خادماً قلل رفع forks من 1 إلى 20 زمن ping من 14 إلى 4.9 ثانية، وكلف جمع الحقائق نصف زمن التشغيل وألغته ذاكرة الحقائق، وأنقص pipelining الزمن 15 في المئة، وتعطيل تعدد الاتصال ضاعفه قرابة ثلاث مرات، وقلصت free زمن الخوادم البطيئة إلى ما بين النصف وثلاثة الأرباع. والتحديث المتدرج بـ serial أوقف نشراً فاشلاً بعد ستة خوادم وترك 14 دون لمس.