تخطيط التعافي من الكوارث: حساب RPO وRTO بالقياس بدل التقدير
 aldawsari
تخطيط التعافي من الكوارث يدور حول رقمين: RPO، أي كم من البيانات تقبل أن تخسر مقيساً بالزمن، وRTO، أي كم من الوقت تقبل أن تبقى الخدمة متوقفة. والخطأ الشائع أن يُكتب الرقمان في وثيقة من التقدير، ثم يُكتشف يوم الكارثة أن النسخة الأخيرة أقدم مما ظُن، وأن الاستعادة أبطأ مما كُتب. وفي هذا المقال نقيس الرقمين بدل تقديرهما: نشغل قاعدة بيانات SQLite تستقبل نحو عشرة طلبات في الثانية، وننسخها احتياطياً بفواصل مختلفة، ونحذفها فجأة لنعد الطلبات الضائعة، ثم نستعيد بيانات بحجم 110 ميغابايت بثلاث طرق ونقيس كل خطوة من خطوات العودة.
نمر بتعريف الرقمين، ثم RPO بالتجربة، ثم مكونات RTO بالقياس، ثم تصنيف الخدمات، ثم قاعدة 3-2-1، وأخيراً كتيب التشغيل والتمرين.
الرقمان على خط الزمن
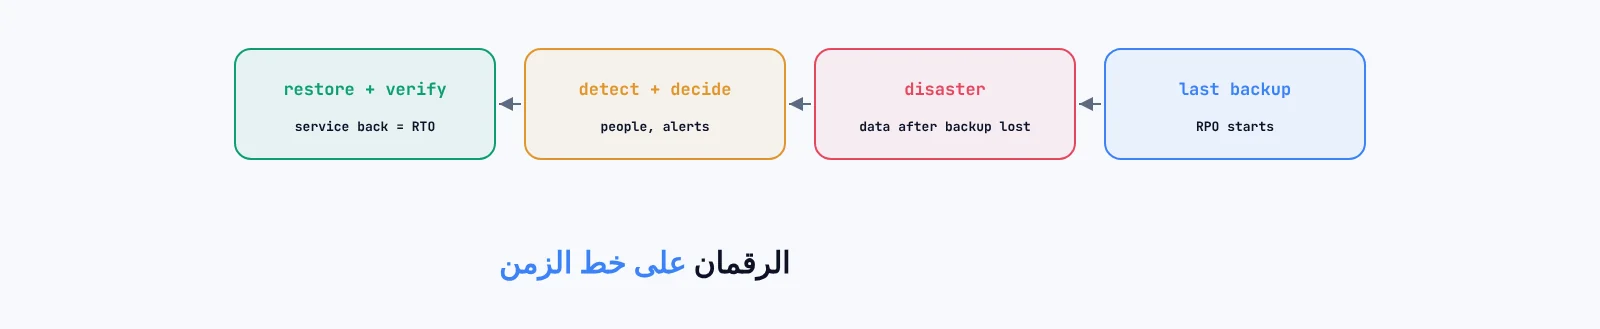
ارسم خط الزمن: آخر نسخة احتياطية ناجحة، ثم لحظة الكارثة، ثم لحظة عودة الخدمة. ما بين آخر نسخة والكارثة بيانات ضاعت، وأطول مدة ممكنة لها هي RPO. وما بين الكارثة والعودة توقف، وحده الأعلى المقبول هو RTO. والرقمان قراران تجاريان قبل أن يكونا تقنيين: متجر يخسر طلبات كل دقيقة يحتاج RPO قصيراً، ومدونة يكفيها نسخ يومي. ودور المدير أن يقيس ما تحققه أنظمته فعلاً ويقارنه بما يطلبه أصحاب الخدمة، لا أن يكتب أرقاماً لا يعرف إن كانت تتحقق.
RPO بالتجربة: فاصل النسخ هو الخسارة
# writer: one insert + commit every 0.1 s; backup with sqlite3 .backup() every INTERVAL s
# disaster: the live database file is deleted; restore = newest backup
con.execute("insert into orders(t) values (?)", (time.time(),)); con.commit()
if time.time() >= next_bk:
    dst = sqlite3.connect(f"{bdir}/b{backups:03d}.db"); con.backup(dst); dst.close()
crash just before the next backup (run 44.8 s)
interval=15s  backups=2   written=437  in backup=294  lost 143 rows = 14.8 s
interval=5s   backups=8   written=438  in backup=392  lost  46 rows =  4.8 s
interval=1s   backups=44  written=436  in backup=430  lost   6 rows =  0.7 s

crash 2 s after a backup (run 47 s)
interval=15s  lost 18 rows = 2.0 s     interval=5s  lost 19 rows = 2.1 s     interval=1s  lost 9 rows = 1.0 s
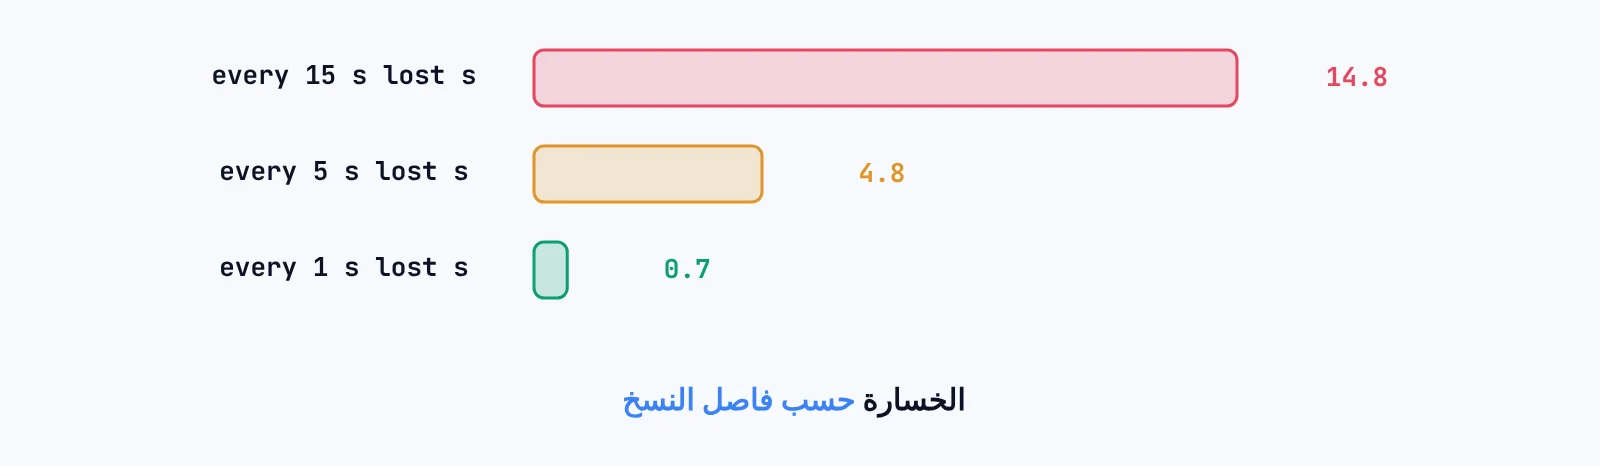
صغّرنا الزمن من ساعات إلى ثوانٍ حتى تكتمل التجربة في دقائق، والمبدأ لا يتغير. حين وقعت الكارثة قبل النسخة التالية مباشرة ضاع ما يقارب الفاصل كله: 14.8 ثانية مع فاصل 15، و4.8 مع فاصل 5، و0.7 مع فاصل ثانية. وحين وقعت بعد نسخة بثانيتين ضاع ثانيتان تقريباً مهما كان الفاصل. فالخسارة الفعلية تتراوح بين الصفر والفاصل، والتخطيط يكون للأسوأ: RPO يساوي فاصل النسخ مضافاً إليه زمن النسخة نفسها. فإن طُلب RPO دقيقة واحدة فالنسخ اليومي لا يحققه مهما كانت جودته، والحل نسخ مستمر لسجل المعاملات أو نسخة متماثلة على خادم آخر.
RTO بالقياس: كل خطوة لها زمن
data: 1242 files, 110 MB, local disk, warm cache

step                                         time
restore: rsync from a local snapshot         396 ms
restore: extract tar.zst (116 MB archive)    180 ms
restore: restic 0.16.4 restore latest       1181 ms
verify: sha256sum -c on 1242 files           110 ms
start service + first good HTTP 200           92 ms
detect + decide                              not measurable in a lab: depends on monitoring and people
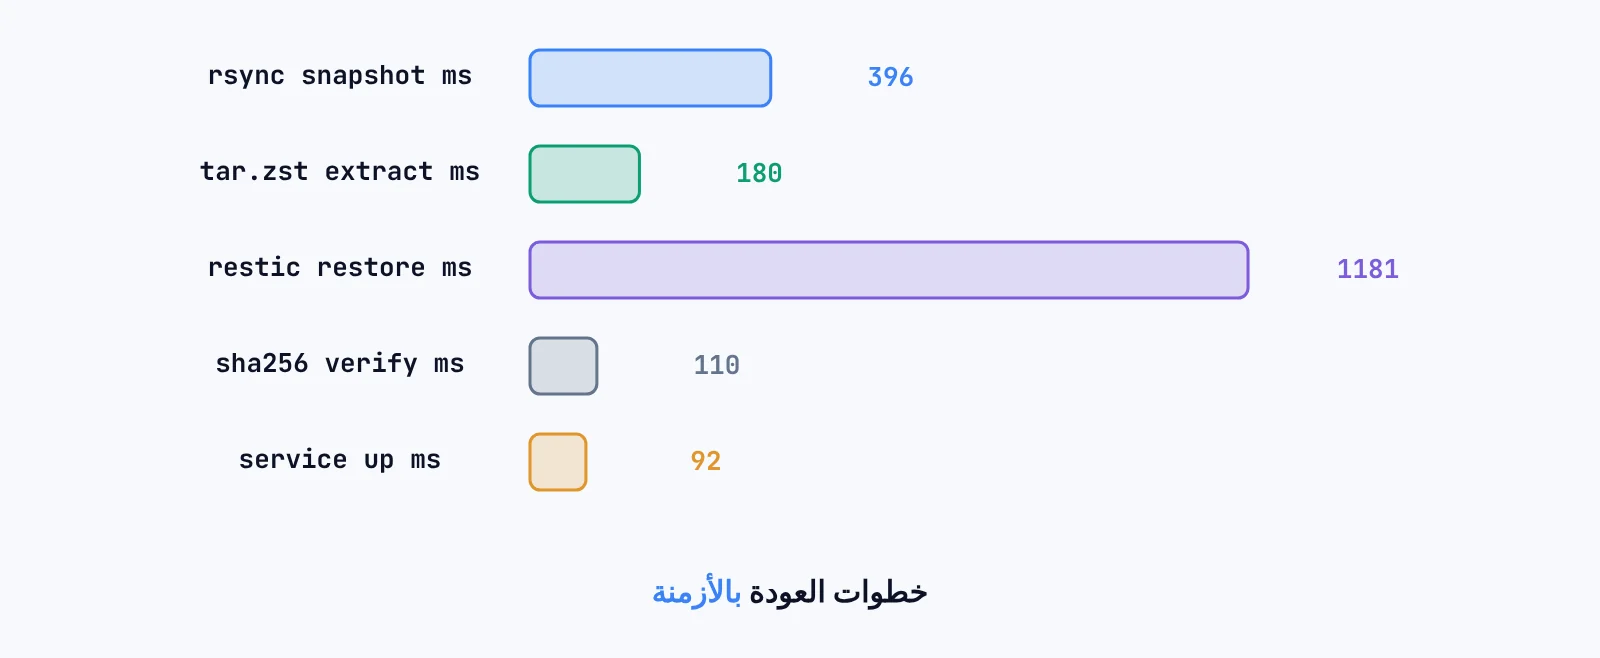
RTO ليس زمن الاستعادة وحده، بل مجموع خطوات: أن تعرف أن هناك مشكلة، وأن تقرر الاستعادة، وأن تنقل البيانات، وأن تتحقق منها، وأن تشغل الخدمة وتتأكد أنها تجيب. قسنا الخطوات التقنية على 110 ميغابايت: الاستعادة بين 180 مللي ثانية و1.2 ثانية حسب الطريقة، والتحقق 110 مللي ثانية، والتشغيل حتى أول رد صحيح 92 مللي ثانية، والملفات المستعادة بالطرق الثلاث متطابقة. لكن هذه أرقام قرص محلي وذاكرة مؤقتة دافئة، وعلى بياناتك الحقيقية عبر الشبكة ستكون أكبر بكثير، فقِسها على بياناتك لا على هذا الجدول. والخطوتان الأوليان لا تُقاسان في مختبر، وغالباً هما الأطول: تنبيه لا يصل ليلاً قد يضيف ساعات، وهذا ما تعالجه المراقبة بـ Prometheus وGrafana.
تصنيف الخدمات
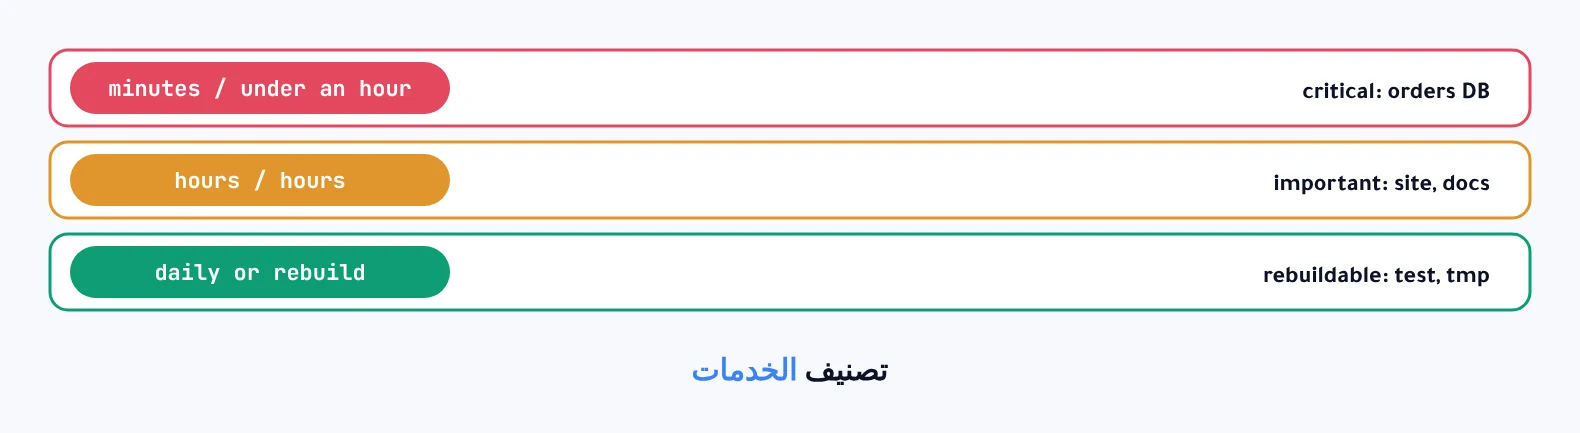
لا تحتاج كل خدمة الرقمين نفسيهما، وتطبيق الأقسى على الجميع مكلف بلا داع. صنف الخدمات في فئات: فئة حرجة كقاعدة بيانات الطلبات، يُقاس فيها RPO بالدقائق وRTO بأقل من ساعة، وتحتاج نسخاً مستمراً أو خادماً احتياطياً جاهزاً. وفئة مهمة كالموقع والمستندات، يكفيها نسخ كل بضع ساعات واستعادة في ساعات. وفئة يمكن إعادة بنائها كخوادم الاختبار والملفات المؤقتة، يكفيها نسخ يومي أو إعادة إنشاء من الكود. واكتب لكل خدمة مصدر بياناتها وطريقة نسخها ومن يملك قرار الاستعادة.
قاعدة 3-2-1
3 copies   the live data + 2 backups          (here: live db, local snapshot, restic repository)
2 media    not all on the same disk or system  (snapshot and repository shared one disk in this lab)
1 offsite  another place, account and credentials
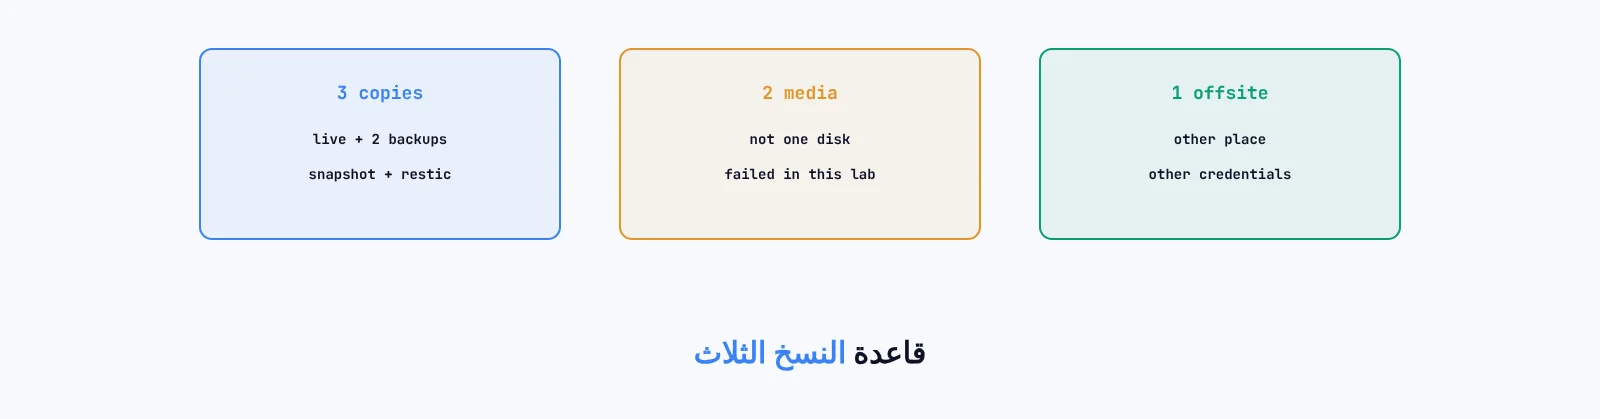
القاعدة تحمي من الكوارث التي لا تحمي منها النسخة الواحدة: ثلاث نسخ من البيانات، على نوعين من التخزين، وواحدة منها خارج المكان. وفي مختبرنا كانت اللقطة ومستودع restic على القرص نفسه، فهما يحققان النسخ الثلاث لا الشرطين الآخرين، ولو تلف القرص لضاع الجميع. والنسخة البعيدة يجب أن تكون بحساب وصلاحيات مختلفة، حتى لا يستطيع مهاجم سيطر على الخادم أن يحذفها، وأحد الحلول أن يسحب خادم النسخ البيانات بدل أن يدفعها الخادم الأصلي. وطريقة بناء النسخ المحلية والتحقق منها في سكربتات النسخ الاحتياطي الآلي.
كتيب التشغيل والتمرين
runbook: orders database (example built from this lab)
1. confirm the failure: health check fails, database file missing
2. stop writers: systemctl stop app
3. restore newest backup:  restic restore latest --target /srv/restore     (measured 1181 ms for 110 MB)
4. verify: sha256sum -c manifest  or  PRAGMA integrity_check              (measured 110 ms)
5. start and test: systemctl start app; curl -f http://127.0.0.1/health    (measured 92 ms)
6. record: time of failure, time of return, rows lost, what was slow
الخطة التي لم تُجرب مجرد وثيقة. اكتب الخطوات بالأوامر الفعلية لا بالوصف، ونفذها كاملة على خادم اختبار مرة كل فترة، وسجل زمن كل خطوة كما فعلنا هنا. والتمرين يكشف ما لا تكشفه القراءة: كلمة مرور المستودع غير موجودة إلا على الخادم الذي تعطل، أو نسخة لم تكتمل منذ أسابيع، أو خطوة تحتاج شخصاً في إجازة. وبعد كل تمرين قارن الأرقام المقاسة بالأهداف، فإن كانت الاستعادة أطول من RTO المطلوب فالحل تغيير الطريقة لا تعديل الهدف على الورق.
أخطاء شائعة
حساب RPO من متوسط الخسارة
الخسارة في تجربتنا بلغت الفاصل كله حين وقعت الكارثة قبل النسخة، فخطط للأسوأ.
اعتبار RTO زمن الاستعادة فقط
الاكتشاف والقرار والتحقق جزء منه، وغالباً أطول من نقل البيانات.
كلمة مرور النسخ على الخادم وحده
احفظ مفاتيح المستودع في مكان مستقل، وإلا ضاعت مع الخادم.
نسخ لا يُتحقق منها
أضف التحقق إلى كل تمرين، فالاستعادة الناجحة ليست بالضرورة بيانات سليمة.
أسئلة يطرحها الناس
هل يغني خادم متماثل عن النسخ الاحتياطي؟
لا، فالتماثل ينقل الحذف الخاطئ والتلف فوراً، وهو يقصر RTO لكنه لا يحمي من الأخطاء المنطقية.
ما الفرق بين التعافي من الكوارث واستمرارية الأعمال؟
التعافي يعيد الأنظمة التقنية، واستمرارية الأعمال تشمل كيف يعمل الناس والعملاء أثناء التوقف.
الخلاصة
مع عشرة طلبات في الثانية ضاع 143 طلباً أي 14.8 ثانية بفاصل نسخ 15 ثانية، و46 بفاصل 5، و6 بفاصل ثانية، فـ RPO هو الفاصل في أسوأ حالاته. وخطوات RTO التقنية على 110 ميغابايت قيست بين 180 و1181 مللي ثانية للاستعادة و110 للتحقق و92 للتشغيل، بينما الاكتشاف والقرار لا يُقاسان إلا بتمرين حقيقي. فاكتب الأهداف لكل فئة، وقِس، وقارن.